博客

  • 数据库IO性能优化思考

    一、数据与WAL分离

    务必将WAL日志(pg_wal目录)放在独立的物理磁盘或高性能分区,隔离数据文件写入压力,对提升性能至关重要

    二、文件系统优化

    文件系统选择:优先选择 XFS,尤其是在大文件和高并发的数据库场景下,实测4K随机写性能比 ext4 提升约 25%。
    文件系统4K对齐:创建时使用 mkfs.xfs -f -s size=4096 /dev/sdX 确保 4KiB 对齐,这在很多虚拟化环境中效果显著。
    挂载参数优化:如果数据库是 MySQL/PostgreSQL,且使用 XFS 文件系统,可在挂载选项增加参数提升日志子系统吞吐量:
    mount -t xfs -o remount,noatime,nodiratime,logbufs=8,logbsize=256k,inode64,commit=60 /dev/sdX /mnt/db
    noatime,nodiratime:关闭访问时间记录,减少大量微小写 IO(高并发必备)
    commit=60:延长文件系统刷盘间隔(默认 5 秒,降低频繁 fsync)
    async:异步写,数据先落页缓存,再后台刷盘,大幅降低即时 IO 压力
    ext4:barrier=0:关闭 ext4 写屏障(硬件有 RAID 卡 + 电池 BBU 才建议开,断电无风险)
    xfs:logbufs=8,logbsize=256k 放大日志缓冲区,减少元数据刷盘

    三、“磁盘 IO 调度算法”优化

    Linux 不同内核 / 磁盘推荐调度器:
    SSD 固态硬盘:推荐 mq-deadline / none(新版本内核)
    HDD 机械硬盘:推荐 mq-deadline(老内核 deadline)
    严禁 SSD 使用 cfq(完全不适合,队列堆积严重)

    1、临时修改

    查看当前调度器:cat /sys/block/sda/queue/scheduler
    SSD 设置 mq-deadline:echo mq-deadline > /sys/block/sda/queue/scheduler
    老SSD/高速盘设置 none:echo none > /sys/block/sda/queue/scheduler

    2、永久生效

    编辑内核启动参数 /etc/default/grub,添加:elevator=mq-deadline
    然后更新 grub,并重启服务器:grub2-mkconfig -o /boot/grub2/grub.cfg

    四、“块设备队列参数”优化

    针对 IO 队列堆积,util 高的情况,可对快设备队列参数进行优化。
    并发高时默认队列深度太小,请求排队:

    1. 调大队列深度(SSD建议 1024~2048,HDD 256~512)
      echo 1024 > /sys/block/sda/queue/nr_requests
    2. 预读大小(顺序IO调大,随机IO调小)
      随机IO(数据库/小文件):16384
      顺序IO(备份/日志):65536
      echo 16384 > /sys/block/sda/queue/read_ahead_kb
      —以上临时生效,需持久化可使用 udev 规则
  • RAID10和RAID5性能对比测试

    4块磁盘做raid5 或 raid10,无缓存直接写入性能哪种方式更好?为此做了一个简单的测试对比,事实胜于雄辩,我们用实际测试数据来得出结论。

    一、raid无缓存

    3个文件系统:

    ---u01: hdd 4T*4 raid10,raid无缓存
    ---u02: hdd 4T*4 raid5,raid无缓存
    ---u03: ssd 447G*1

    测试结果如下:

    ./testdd.sh /u01 /u02 /u03 > testdd.log.`date +%Y%m%d%H%M` 2>&1 &
    vgraid10_local-lv01  7.3T  100G  7.2T   2% /u01 --- direct写入:38.7 MB/s direct读取:151 MB/s  cache写入:328 MB/s  cache读取:511 MB/s
    vgraid5_local-lv01    11T   88G   11T   1% /u02 --- direct写入:7.4 MB/s  direct读取:128 MB/s  cache写入:77.6 MB/s cache读取:700 MB/s
    vgssd_local-lv01     447G   65G  382G  15% /u03 --- direct写入:147 MB/s  direct读取:189 MB/s  cache写入:387 MB/s  cache读取:512 MB/s

    结论:

    在无缓存(例如RAID卡禁用缓存、设置为Write Through模式,或使用无缓存的RAID卡)的情况下,针对4块磁盘的配置,RAID 10 的直接写入性能【38.7 MB/s】全面且大幅度地优于 RAID 5【7.4 MB/s】。

    二、raid缓存模式

    确认以上测试 u01/u02 是无缓存模式:

    [root@host2 ~]# lsblk
    NAME                   MAJ:MIN RM   SIZE RO TYPE  MOUNTPOINT
    sdc                      8:32   0   7.3T  0 disk  
    └─vgraid10_local-lv01  253:3    0   7.3T  0 lvm   /u01
    sdd                      8:48   0  10.9T  0 disk  
    └─vgraid5_local-lv01   253:4    0  10.9T  0 lvm   /u02
    sdb                      8:16   0 447.1G  0 disk  
    └─vgssd_local-lv01     253:5    0   447G  0 lvm   /u03

    执行 arcconf getconfig 1 ld 显示 Logical Device number 0 和 1 的配置信息:

    [root@host2 ~]# arcconf getconfig 1 ld
    Controllers found: 1
    --------------------------------------------------------
    Logical device information
    --------------------------------------------------------
    Logical Device number 0
       Logical Device name                        : vd1
       Disk Name                                  : /dev/sdc (Disk0) (Bus: 1, Target: 0, Lun: 0)
       Block Size of member drives                : 512 Bytes
       Array                                      : 0
       RAID level                                 : 10
       Status of Logical Device                   : Optimal
       Size                                       : 7630830 MB
       Stripe-unit size                           : 256 KB
       Full Stripe Size                           : 512 KB
       Interface Type                             : Serial ATA
       Device Type                                : Data
       Boot Type                                  : None
       Heads                                      : 255
       Sectors Per Track                          : 32
       Cylinders                                  : 65535
       Caching                                    : Disabled
       Mount Points                               : Not Mounted
       LD Acceleration Method                     : None
       SED Encryption                             : Disabled
       Volume Unique Identifier                   : 600508B1001CF6173057FB8A85255004
    --------------------------------------------------------
       Logical Device segment information
    --------------------------------------------------------
       Segment                                    : Availability (SizeMB, Protocol, Type, Connector ID, Location) Serial Number
    --------------------------------------------------------
       Group 0, Segment 0                         : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:2) WQB0BYF0
       Group 0, Segment 1                         : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:4) WQB0B5PV
       Group 1, Segment 0                         : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:3) WQB0B5V7
       Group 1, Segment 1                         : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:5) V302WXYF
    
    Logical Device number 1
       Logical Device name                        : vd2
       Disk Name                                  : /dev/sdd (Disk0) (Bus: 1, Target: 0, Lun: 1)
       Block Size of member drives                : 512 Bytes
       Array                                      : 1
       RAID level                                 : 5
       Status of Logical Device                   : Optimal
       Parity Initialization Status               : Completed
       Size                                       : 11446245 MB
       Stripe-unit size                           : 256 KB
       Full Stripe Size                           : 768 KB
       Interface Type                             : Serial ATA
       Device Type                                : Data
       Boot Type                                  : None
       Heads                                      : 255
       Sectors Per Track                          : 32
       Cylinders                                  : 65535
       Caching                                    : Disabled
       Mount Points                               : Not Mounted
       LD Acceleration Method                     : None
       SED Encryption                             : Disabled
       Volume Unique Identifier                   : 600508B1001CE4C11BEB914107DF0141
    --------------------------------------------------------
       Array Physical Device Information
    --------------------------------------------------------
       Device ID                                  : Availability (SizeMB, Protocol, Type, Connector ID, Location) Serial Number
    --------------------------------------------------------
       Device 14                                  : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:6) V3039ZHF
       Device 15                                  : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:7) WQB0BY59
       Device 16                                  : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:8) WQB0AW76
       Device 17                                  : Present (3815447MB, SATA, HDD, Connector:CN0, Enclosure:1, Slot:9) VB00EL3F
    
    Command completed successfully.

    关键信息是这两行:

       Caching                                    : Disabled

    在 arcconf 设置 磁盘组的 Caching 为 WB 模式:

    arcconf SETCACHE 1 LOGICALDRIVE 0 con
    arcconf SETCACHE 1 LOGICALDRIVE 1 con

    再次查询,已经强行改成了 缓存模式:

    Caching                                    : Enabled

    再次测试磁盘的IO性能:

    ./testdd.sh /u01 /u02 > testdd.log.`date +%Y%m%d%H%M` 2>&1 &
    vgraid10_local-lv01  7.3T  100G  7.2T   2% /u01 --- direct写入:38.3 MB/s direct读取:400 MB/s  cache写入:303 MB/s  cache读取:526 MB/s
    vgraid5_local-lv01    11T   88G   11T   1% /u02 --- direct写入:7.1 MB/s  direct读取:357 MB/s  cache写入:33.7 MB/s cache读取:350 MB/s

    结论:

    打开RAID卡缓存后,raid5的 direct写入 性能仍然很差【7.1 MB/s】,但是 direct读取 性能有了大幅度提升!【128 MB/s —> 357 MB/s】读取性能飙升而写入性能依旧拉胯,完全符合理论预期。

    最后修改回原来设置:

    因为 raid 卡无后备电池保护,存在丢数据风险。

    arcconf SETCACHE 1 LOGICALDRIVE 0 coff
    arcconf SETCACHE 1 LOGICALDRIVE 1 coff

    三、测试脚本

    vim testdd.sh
    #!/bin/bash
    if [ $# -lt 1 ]; then
      echo "usage: $0 /target1 /target2 /target3 ..."
      exit 1
    fi
    
    while [ $# -gt 0 ]; do
      target=$1
      echo "${target} direct写入:"
      sync && echo 3 > /proc/sys/vm/drop_caches
      time dd if=/dev/zero of=${target}/dd.out bs=8k count=200000 oflag=direct
      echo "${target} direct读取:"
      sync && echo 3 > /proc/sys/vm/drop_caches
      time dd if=${target}/dd.out of=/dev/null bs=8k count=200000 iflag=direct
      echo "${target} cache写入:"
      sync && echo 3 > /proc/sys/vm/drop_caches
      time dd if=/dev/zero of=${target}/dd.out bs=8k count=200000
      echo "${target} cache读取:"
      sync && echo 3 > /proc/sys/vm/drop_caches
      time dd if=${target}/dd.out of=/dev/null bs=8k count=200000
      shift
    done
    
    chmod +x testdd.sh
    ./testdd.sh /u01 /u02 > testdd.log.`date +%Y%m%d%H%M` 2>&1 &
  • 迁移MySQL数据到Oracle实践记录

    一、使用 SQL Developer 将第三方数据库迁移到 Oracle,迁移过程涉及以下步骤

    1、创建迁移资料档案库以便保存有关迁移项目的信息。
    2、创建用作迁移容器的迁移项目。
    3、选择第三方数据库连接。
    4、将第三方元信息捕获至迁移资料档案库。
    5、将捕获的元信息转换为 Oracle 特定的元信息。
    6、将存储程序,触发器,视图等翻译为 Oracle 形式。
    7、生成 Oracle 数据库创建脚本。
    8、将数据从第三方数据库移到 Oracle 数据库。

    1. 删除之前的迁移资料库

    为充分能完成迁移,不知数据库之前有没有迁移过,所以先把原来的迁移资料库删除

    2. 开始迁移操作

    需要首先创建资料档案库,选择目标 Oracle 数据库进行创建,会创建一堆表

    ■ 各种报错,经典错误反复遇见
    执行请求的操作时遇到错误:
    ORA-00942: 表或视图不存在

    二、在 SQL Developer 右键单击源表,菜单选择 Copy To Oracle … 可迁移单表

    1、拷贝表测试:3分钟,效率较低,如果在局域网内部,也许可行,但需提前配置好本工具

    复制的对象:
    [email protected]_rmw.TABLE.a_resquery
    放置目标: [email protected]
    复制 DDL: 是
    不替换 现有对象
    复制数据: 是
    附加 现有对象
    任务成功。
    已复制 1 个表。
    已创建表 a_resquery 并已插入 2,344 行

    2、拷贝表结构:可迅速转换为合适的定义

    复制的对象:
    [email protected]_rmw.TABLE.lx_diangan_jiekou
    放置目标: [email protected]
    复制 DDL: 是
    不替换 现有对象
    复制数据: 否
    任务成功。
    已复制 1 个表。
    已创建表 lx_diangan_jiekou 并已插入 0 行

    3、dbeaver 导出 csv,使用 sqldeveloper 直接 copy 表结构到 oracle,再使用 dbeaver 将 csv 导入 oracle

    文件(数据量)大小受限制
    150M ok,211M(80M),ok,298M,ok
    500M数据量大小,pc_pon_query_his_log,耗时:导出 67s,导入 98s

    三、结论

    1、直接库级迁移,问题较多;
    2、表级拷贝,适合数据量几百兆级别以下,大数据量无法完成。

  • 瀚高数据库不同版本对实例级用户的支持情况

    V9.5

    [hgadmin@highgov9-5 ~]$ psql --version
    psql (PostgreSQL) 9.5.4
    [hgadmin@highgov9-5 ~]$ psql --help|grep -P "\-u|\-U"
      -u, --instance-user      connect to the database with instance level user
      -U, --username=USERNAME  database user name (default: "hgadmin")
    [hgadmin@highgov9-5 ~]$ psql -udbadmin -p5866 -dpostgres
    psql: FATAL:  instance level role "hgadmin" does not exist

    以上说明这个版本瀚高数据库存在bug,因为已经指定了 dbadmin 实例级用户,却识别成 hgadmin
    解决办法是使用 -u username 的严格格式指定实例级用户:
    psql -u dbadmin -p5866 -dpostgres

    V9.0.1

    [hgadmin@highgov9-0-pg ~]$ psql --version
    psql (PostgreSQL) 14.10
    [hgadmin@highgov9-0-pg ~]$ psql --help|grep -P "\-u|\-U"
      -U, --username=USERNAME  database user name (default: "hgadmin")
  • 使用PBM对MongoDB做物理备份和恢复

    之前文章已详细描述了PBM的安装和入门使用,结论是可大幅提升大数据量的备份效率,本文结合一线 MongoDB 集群的实际部署现状,详细记录使用 PBM 进行物理备份和恢复的操作步骤,供一线直接参考使用。

    一、Make a physical backup

    配置好 pbm 以后,物理备份非常简单:
    pbm backup –type=physical

    二、Restore from a physical backup

    1、恢复之前首先确认当前的备份集:

    Backup snapshots:
      2025-12-10T08:22:10Z <physical> [restore_to_time: 2025-12-10T08:22:12Z]
      2025-12-10T08:33:06Z <logical> [restore_to_time: 2025-12-10T08:53:18Z]
      2025-12-12T06:43:30Z <physical> [restore_to_time: 2025-12-12T06:43:32Z]

    2、分片集群恢复

    注意:恢复操作会自动清空当前的数据,切记谨慎操作!

    1). 停止 balancer

    mongos>
    sh.stopBalancer()

    2). 关闭所有 mongos,阻止客户端访问

    killall mongos

    3). 禁用 PITR

    pbm config –set pitr.enabled=false

    4). 全集恢复

    pbm restore "2025-12-12T06:43:30Z"

    [mongod@node1:1 /u01/nfs/ynzybak_mongodb_pbm]$ pbm restore "2025-12-12T06:43:30Z"
    Starting restore 2025-12-12T07:17:14.062699954Z from '2025-12-12T06:43:30Z'...............................................Restore of the snapshot from '2025-12-12T06:43:30Z' has started.
    Check restore status with: pbm describe-restore 2025-12-12T07:17:14.062699954Z -c </path/to/pbm.conf.yaml>
    No other pbm command is available while the restore is running!

    以上输出可见,恢复期间切勿执行其他的 pbm 操作,以免导致意外!
    并且,恢复期间仅可以通过以下方式检查恢复状态:
    pbm describe-restore 2025-12-12T07:17:14.062699954Z -c /u01/mongodb/conf/pbm_config.yaml

    [mongod@node1:1 /u01/nfs/ynzybak_mongodb_pbm]$ pbm describe-restore 2025-12-12T07:17:14.062699954Z -c /u01/mongodb/conf/pbm_config.yaml
    name: "2025-12-12T07:17:14.062699954Z"
    opid: ""
    backup: ""
    type: physical
    status: running
    last_transition_time: "2025-12-12T07:18:00Z"
    replsets:
    - name: configs
      status: done
      last_transition_time: "2025-12-12T07:22:29Z"
      nodes:
      - name: node1:21000
        status: done
        last_transition_time: "2025-12-12T07:22:24Z"
      - name: node2:21000
        status: done
        last_transition_time: "2025-12-12T07:22:24Z"
      - name: node3:21000
        status: done
        last_transition_time: "2025-12-12T07:22:23Z"
    - name: shard1
      status: down
      last_transition_time: "2025-12-12T07:19:06Z"
      nodes:
      - name: node1:27001
        status: done
        last_transition_time: "2025-12-12T07:22:23Z"
      - name: node2:27001
        status: running
        last_transition_time: "2025-12-12T07:17:49Z"
      - name: node3:27001
        status: running
        last_transition_time: "2025-12-12T07:17:49Z"

    以上输出可见,部分节点的状态是 running ,表明正在恢复中。
    最后恢复完毕之后的状态如下:

    [mongod@node1:1 /u01/nfs/ynzybak_mongodb_pbm]$ pbm describe-restore 2025-12-12T07:17:14.062699954Z -c /u01/mongodb/conf/pbm_config.yaml
    name: "2025-12-12T07:17:14.062699954Z"
    opid: 693bc17a3c10278f23378457
    backup: "2025-12-12T06:43:30Z"
    type: physical
    status: done
    last_transition_time: "2025-12-12T07:23:08Z"
    replsets:
    - name: configs
      status: done
      last_transition_time: "2025-12-12T07:22:29Z"
      nodes:
      - name: node1:21000
        status: done
        last_transition_time: "2025-12-12T07:22:24Z"
      - name: node2:21000
        status: done
        last_transition_time: "2025-12-12T07:22:24Z"
      - name: node3:21000
        status: done
        last_transition_time: "2025-12-12T07:22:23Z"
    - name: shard1
      status: done
      last_transition_time: "2025-12-12T07:23:03Z"
      nodes:
      - name: node1:27001
        status: done
        last_transition_time: "2025-12-12T07:22:23Z"
      - name: node2:27001
        status: done
        last_transition_time: "2025-12-12T07:22:39Z"
      - name: node3:27001
        status: done
        last_transition_time: "2025-12-12T07:22:32Z"

    可见,各个副本集、节点的状态均为 done,表明恢复完成。

    4). PITR 恢复

    基于时间点的恢复如下操作:
    pbm restore –time="2023-02-22T08:30:00"
    本次暂未执行,掠过。

    5). Post-restore steps

    恢复完成后,执行如下步骤。
    —Remove the contents of the datadir on any arbiter nodes

    当前一线集群架构未采用仲裁节点,所以不涉及

    —Restart all mongod nodes

    mongod -f ${MongoDir}/conf/config.conf
    mongod -f ${MongoDir}/conf/shard1.conf

    —Restart all pbm-agents

    pbm-agent --mongodb-uri "mongodb://pbmuser:passwd@localhost:21000/?authSource=admin" > /u01/mongodb/pbm-log/pbm-agent.$(hostname -s).21000.log 2>&1 &
    pbm-agent --mongodb-uri "mongodb://pbmuser:passwd@localhost:27001/?authSource=admin" > /u01/mongodb/pbm-log/pbm-agent.$(hostname -s).27001.log 2>&1 &

    —Run the following command to resync the backup list with the storage:

    更新备份集信息
    pbm config --force-resync -w

    —Start the balancer and start mongos nodes.

    mongos -f ${MongoDir}/conf/mongos.conf
    sh.startBalancer()

    —启用 PITR
    pbm config --set pitr.enabled=true

  • 使用PBM提高MongoDB备份效率

    项目地大量使用社区版MongoDB数据库,用来存放重要工单数据,随着业务量增长,数据规模越来越大,每天的备份任务执行时间越来越长。目前某项目地数据规模统计如下:

    [mongod@mongodb02 mongodb]$ du -sh *
    16K     conf
    13G     config
    45G     mongos
    1.4T    shard1
    0       shard2
    0       shard3
    [mongos] flowtest> show dbs
    admin     204.00 KiB
    config     37.21 MiB
    flowtest     1.37 TiB
    [mongos] flowtest> db.stats()
    {
      collections: 13,
      objects: 268389871,
      dataSize: 6290739041372,
      storageSize: 1483442253824
    }

    可见实际的数据量达到了6T以上,数据库大小1.4T,实际磁盘空间占用也是1.4T。
    目前的原生备份方法是 mongodump 压缩方式,因为磁盘空间不足,只能采用压缩方式备份,否则3天的备份占用就达到20T。原生备份方法效率较低,当前6T的数据备份需要耗时23个小时,几乎要达到每天备份的极限了。
    由于社区版本身的限制,本次采用 percona 的 备份恢复工具 pbm (Percona Backup for MongoDB),大大缩短了备份时间,以下是具体的实践指南。
    备注:网上暂无比较严谨、可用的中文版pbm备份恢复实践指南,本次认真研读官方文档,按照我们的实际部署情况执行操作,具有较强的指导意义。尤其是如何跳过安全验证这一步,实乃神来之笔。另外部分执行步骤按照官方文档无法执行,只能按照自己的理解来操作,最终达到成功高效完成备份的目的。
    首先,最重要的是所有的参考一定是官方文档:
    https://docs.percona.com/percona-backup-mongodb/
    Percona Backup for MongoDB (PBM) is an open source and distributed solution for consistent backups and restores of MongoDB sharded clusters and replica sets to a specific point in time.
    本次实践所有的操作来源均来自官网指南。

    一、在每个 mongod 节点安装 pbm

    下载pbm的二进制文件、解压缩、配置环境变量

    wget https://downloads.percona.com/downloads/percona-backup-mongodb/percona-backup-mongodb-2.12.0/binary/tarball/percona-backup-mongodb-2.12.0-x86_64.tar.gz
    cd /u01
    tar -xf /home/nrms/pbm/percona-backup-mongodb-2.12.0-x86_64.tar.gz
    export PATH=/u01/percona-backup-mongodb-2.12.0:$PATH

    这个环境变量需要配置到mongod用户的.bash_profile文件。
    我们的生产环境是分片集群3个节点,都配置了config服务、shard服务,目前均配置了一个分片集shard1,这两类服务都是mongod服务,所以在3个节点部署pbm软件即可。

    二、Configure authentication in MongoDB

    配置鉴权认证

    1、Create a corresponding pbm user in the admin database

    在admin库创建pbm用户。
    Do this step on a primary node of each replica set. In a sharded cluster, this means on every shard replica set and the config server replica set.
    按照以上官网要求,需要在每一个副本集的主节点执行。
    To list all the host+port lists for the shard replica sets in a cluster, run the following command:
    db.getSiblingDB("config").shards.find({}, {"host": true, "_id": false})
    The replica set name at the front of these “host” strings will have to be placed as a “/?replicaSet=xxxx” argument in the parameters part of the connection URI (see below).
    这是说明如何列出分片副本集。不过关于replicaSet=xxxx的要求,实践证明是错误的,不需要。
    创建角色和用户的操作命令是:

    db.getSiblingDB("admin").createRole({ "role": "pbmAnyAction",
          "privileges": [
             { "resource": { "anyResource": true },
               "actions": [ "anyAction" ]
             }
          ],
          "roles": []
       });
    
    db.getSiblingDB("admin").createUser({user: "pbmuser",
          "pwd": "mypassword",
          "roles" : [
             { "db" : "admin", "role" : "readWrite", "collection": "" },
             { "db" : "admin", "role" : "backup" },
             { "db" : "admin", "role" : "clusterMonitor" },
             { "db" : "admin", "role" : "restore" },
             { "db" : "admin", "role" : "pbmAnyAction" }
          ]
       });

    以上命令在后面步骤执行,此处只是列出指令。

    1)、首先在config服务器执行创建

    我们的config服务是21000端口,执行如下进入config主节点:
    mongosh mongodb://’admin’:’mypassword’@99.99.99.99:21000/admin?authSource=admin
    然后执行以上指令创建pbm角色、用户。

    2)、然后在shard服务器执行创建

    我们的shard服务是27001端口,然而问题来了,我的mongodb分片集群配置了安全认证,无法直接访问mongod,只能通过mongos访问分片数据。但是pbm-agent只能直连分片副本集,无法通过mongos配置,这个问题怎么解决?
    我们采用先关闭安全认证创建pbm角色用户,然后再打开安全认证的方式,成功绕过了这一个无法进行的难关,也是本次实践的神来之笔。解决办法:
    1、停掉集群,关闭安全认证,启动集群,在shard上建立pbm角色及用户;
    2、停掉集群,打开安全认证,启动集群,这样就可以在后面成功启动pbm-agent。
    关闭、打开安全认证的方法是修改shard的配置文件如下两行:

    security:
      keyFile: /u01/mongodb/conf/mongo.keyfile

    没这两行启动服务就是关闭安全认证,加上就是打开,不再赘述。
    关闭安全认证后,在shard的主节点执行如下进入mogonsh:
    mongosh –port 27001
    然后执行以上指令创建pbm角色、用户。

    2、Set the MongoDB connection URI for pbm-agent

    Execute this step on each node where pbm-agent is installed.
    对于我们的环境,在3个节点均如下配置pbm-agent指令:暂不执行

    pbm-agent --mongodb-uri "mongodb://pbmuser:mypassword@localhost:27001/?authSource=admin" > /u01/percona-backup-mongodb-2.12.0/pbm-agent.$(hostname -s).27001.log 2>&1 &
    pbm-agent --mongodb-uri "mongodb://pbmuser:mypassword@localhost:21000/?authSource=admin"> /u01/percona-backup-mongodb-2.12.0/pbm-agent.$(hostname -s).21000.log 2>&1 &

    我加上了日志输出路径。

    3、Set the MongoDB connection URI for pbm CLI

    export PBM_MONGODB_URI="mongodb://pbmuser:mypassword@node1:21000,node2:21000,node3:21000/?authSource=admin"

    建议将这个环境变量设置到mongod用户的配置文件.bash_profile

    三、Configure remote backup storage

    这一步配置nfs文件存储,需在pbm-agent的每个节点挂载好nfs,确保权限赋予mongod用户。

    cd /u01/percona-backup-mongodb-2.12.0
    vim pbm_config.yaml
    storage:
      type: filesystem
      filesystem:
        path: /u01/nfs/ynzybak_mongodb_pbm

    执行以下命令将配置写入配置库:

    pbm config --file pbm_config.yaml

    注:因为是将配置信息写入配置库,所以只需在一个节点执行此步骤即可。

    四、Start the pbm-agent process

    在3个节点,执行上面配置好的pbm-agent指令,确保如下状态:

    [mongod@mongodb07 u01]$ pbm status
    Cluster:
    ========
    shard1:
      - node1:27001 [P]: pbm-agent [v2.12.0] OK
      - node2:27001 [S]: pbm-agent [v2.12.0] OK
      - node3:27001 [S]: pbm-agent [v2.12.0] OK
    configs:
      - node1:21000 [P]: pbm-agent [v2.12.0] OK
      - node2:21000 [S]: pbm-agent [v2.12.0] OK
      - node3:21000 [S]: pbm-agent [v2.12.0] OK

    五、阶段总结

    此时,就可以畅快的执行pbm相关备份恢复操作了。强烈建议在此刻,在官网花半小时学习一下pbm相关的操作指令,比如这些常用的操作命令:
    pbm help
    pbm help backup
    pbm logs
    pbm list
    pbm config
    pbm status

    六、Make a physical backup

    pbm backup --type=physical
    Starting backup '2025-11-07T08:09:48Z'.................................Error: get backup metadata: get: context deadline exceeded

    可见报错了,原因:pbm 不支持 社区版 monogodb 的 physical backup, 只支持 logical backup
    其实在错误日志可看到:

    pbm logs -n shard1 -s E
    [backup/2025-11-07T08:09:48Z] node check: full physical backup works since Percona Server for MongoDB 4.2.15, 4.4.6

    七、Make a logical backup

    $ pbm backup --type=logical
    Snapshot backup "2025-11-07T08:38:14Z", started at 2025-11-07T08:38:14Z.
    注:使用 pbm cancel-backup 可取消备份
    $ pbm list
    Backup snapshots:
      2025-11-07T08:38:14Z <logical> [restore_to_time: 2025-11-07T10:16:59]

    耗时统计:650G数据,备份耗时:1h38m

    查看备份日志:
    pbm logs –tail=100 –event=backup
    pbm logs –tail=100 –event=backup/2025-11-07T08:38:14Z
    查看备份详情:
    pbm describe-backup "2025-11-07T08:38:14Z"
    查看关于 shard1 的备份错误:
    pbm logs -n shard1 -s E

    八、总结

    以上可见,默认的备份效率还是非常高的,比社区版原生的压缩备份方式提高了至少好几倍,可有效降低备份时间过长的风险。
    后续将择机进一步探讨物理备份恢复及增量备份恢复方法,彻底解决MongoDB的备份及恢复问题。

  • 使用benchmarksql测试数据库处理能力

    我们所处行业的核心应用业务,当前还是传统的OLTP业务,应用系统使用 java 开发,并且不建议使用存储过程,使用 benchmarksql 压测数据库最公平,既可以测试数据库性能,也可以测试JDBC驱动。

    一、tpmC性能测试要点

    1、流量指标(Throughput,简称tpmC)

    按照TPC组织的定义,流量指标描述了系统在执行支付操作、订单状态查询、发货和库存状态查询这4种交易的同时,每分钟可以处理多少个新订单交易。所有交易的响应时间必须满足TPC-C测试规范的要求,且各种交易数量所占的比例也应该满足TPC-C测试规范的要求。在这种情况下,流量指标值越大说明系统的联机事务处理能力越高。

    2、测试时长

    benchmarksql跑的时间越长,数据库也会越大,一般来说当数据库大小超过数据库共享缓存的3倍后,性能就会开始明显的下降。

    3、cpu负荷

    可使用htop监控数据库服务端和tpcc客户端CPU利用情况,最佳性能测试情况下,各个业务CPU的占用率应尽可能高。如果有CPU占用率没有达标,可能是绑核方式不对或其他问题,可采用 cpu 绑定技术。

    4、warehouses

    指定仓库数,仓库数决定性能测试的成绩。如果期望有较高测试结果,仓库数就不能太低。生产环境机器测试,建议 5000 仓库起步(5000仓与我们的业务场景不太相符,建议100仓)。

    5、terminals

    指定性能压测时的并发数,建议并发数不要高于仓库数 * 10。否则,会有不必要的锁等待。在生产环境中,该并发数设置到 1000 就很高了。一般环境测试建议从 100 开始。

    6、runMins

    指定性能测试持续的时间,时间越久,越能考验数据库的性能和稳定性。建议不要少于 10 分钟,生产环境中机器建议不少于 1 小时。

    二、测试步骤

    1、benchmarksql 下载

    wget https://gitee.com/MapLover/benchmarksql5.1/repository/archive/master.zip

    2、Requirements

    ■ 配置 ant java

    yum install -y ant java
    如果无法安装 ant,安装java后下载ant
    https://ant.apache.ac.cn/bindownload.cgi 确认 ant 的最新版本
    https://mirrors.nju.edu.cn/apache/ant/binaries/apache-ant-1.10.14-bin.tar.gz
    仅 bin 和 lib 目录是运行 Ant 所必需的,安装 Ant,请选择一个目录并将发行版文件复制到该目录,此目录将被称为 ANT_HOME
    运行 Ant 之前,需进行一些额外的设置,除非安装的是 RPM 版本
    1、将 bin 目录添加到路径中
    2、将 ANT_HOME 环境变量设置为安装 Ant 的目录
    3、可选地,设置 JAVA_HOME 环境变量
    ln -s /u01/nfs/soft/apache-ant-1.10.14 /opt/ant
    vim /etc/profile
    export JAVA_HOME=/u01/app/oracle/product/19.3.0/db_1/jdk
    export ANT_HOME=/opt/ant
    export PATH=$JAVA_HOME/bin:$ANT_HOME/bin:$PATH

    ■ 配置 python

    采集cpu、disk、network等相关性能信息时需要调用python程序,支持的python版本是2,如果采用3版本会报错:

    2024-07-31 15:15:52: osCollectorScript=./misc/os_collector_linux.py
    2024-07-31 15:15:52: osCollectorInterval=1
    2024-07-31 15:15:52: osCollectorSSHAddr=null
    2024-07-31 15:15:52: osCollectorDevices=net_ens39 blk_sda
    2024-07-31 15:15:52: Term-00,
      File "<stdin>", line 63
        print ",".join([str(x) for x in sysInfo])
                ^
    SyntaxError: invalid syntax
    2024-07-31 15:15:52: OSCollector, unexpected EOF while reading from external helper process

    因为信息采集是在数据库端执行的,下载
    https://mirrors.nju.edu.cn/python/2.7.18/Python-2.7.18.tgz
    解压缩、配置:
    ./configure –enable-optimizations –prefix=/usr/local/python2.7/
    修改配置文件:

    vim Modules/Setup
    _ssl _ssl.c \
            -DUSE_SSL -I$(SSL)/include -I$(SSL)/include/openssl \
            -L$(SSL)/lib -lssl -lcrypto

    默认这块是注释的,放开注释即开。这块功能是开启SSL模块,不然会出现安装完毕后,提示找不到ssl模块的错误。
    编译、安装:
    make -j8 && make install
    建新软链:
    mv /usr/bin/python /usr/bin/python.bak
    ln -s /usr/local/python2.7/bin/python2.7 /usr/bin/python
    python -V

    3、Compile the BenchmarkSQL source code

    总算可以编译 BenchmarkSQL 了:

    [root@BC86 benchmarksql5.1-master]# ant
    Buildfile: /u01/nfs/soft/benchmark/benchmarksql5.1-master/build.xml
    init:
        [mkdir] Created dir: /u01/nfs/soft/benchmark/benchmarksql5.1-master/build
    compile:
        [javac] Compiling 11 source files to /u01/nfs/soft/benchmark/benchmarksql5.1-master/build
    dist:
          [jar] Building jar: /u01/nfs/soft/benchmark/benchmarksql5.1-master/dist/BenchmarkSQL-5.1.jar
    BUILD SUCCESSFUL

    —如果遇见如下错误,需配置 JAVA_HOME:

    BUILD FAILED
    /u01/nfs/soft/benchmarksql5.1-master/build.xml:24: Unable to find a javac compiler;
    com.sun.tools.javac.Main is not on the classpath.
    Perhaps JAVA_HOME does not point to the JDK.
    It is currently set to "/usr/lib/jvm/java-1.8.0-openjdk-1.8.0.312.b07-11.oe2203.aarch64/jre"

    4、Create the benchmark configuration file

    创建测试的配置文件:
    cd run
    cp props.pg my_postgres.properties

    vim my_postgres.properties
    ---
    db=postgres
    driver=org.postgresql.Driver
    conn=jdbc:postgresql://192.168.10.108:5432/postgres
    user=postgres
    password=passwdsefsdfsdf
    
    //每个W约100MB,则100个约10G
    warehouses=5
    loadWorkers=5
    
    //终端数,即并发客户端数量,通常设置为CPU线程总数的2~6倍
    terminals=5
    
    //To run specified transactions per terminal- runMins must equal zero
    //每个终端运行的固定事务数量,如该值为10, 则每个terminal运行10个事务,如果有32个终端,那整体运行320个事务后,测试结束。该参数配置为非0值时,下面的runMins参数必须设置为0。
    runTxnsPerTerminal=0
    
    //To run for specified minutes- runTxnsPerTerminal must equal zero
    //runMins表示要压测的时间长度,单位为分钟。该值为非0值时,runTxnsPerTerminal参数必须设置为0。这两个参数不能同时设置为正整数,如果设置其中一个,另一个必须为0,主要区别是runMins定义时间长度来控制测试时间;runTxnsPerTerminal定义事务总数来控制时间。
    runMins=5
    
    //Number of total transactions per minute
    limitTxnsPerMin=100000000
    
    //Set to true to run in 4.x compatible mode. Set to false to use the
    //entire configured database evenly.
    terminalWarehouseFixed=true
    
    //The following five values must add up to 100
    //The default percentages of 45, 43, 4, 4 & 4 match the TPC-C spec
    newOrderWeight=45
    paymentWeight=43
    orderStatusWeight=4
    deliveryWeight=4
    stockLevelWeight=4
    
    // Directory name to create for collecting detailed result data.
    // Comment this out to suppress.
    resultDirectory=pg_result_%tY-%tm-%td_%tH%tM%tS
    osCollectorScript=./misc/os_collector_linux.py
    osCollectorInterval=1
    //[email protected]
    osCollectorDevices=net_ens39 blk_sda

    —如下官方文档供参考:

    Note that the provided example configuration is meant to test the functionality of your setupr. That benchmarksql can connect to the database and execute transactions. [■■■That configuration is NOT a benchmark run.■■■] To make it into one you need to have a configuration that matches your database server size and workload. Leave the sizing for now and perform a first functional test.
    The BenchmarkSQL database has an initial size of approximately 100-100MB per configured warehouse. A typical setup would be a database of 2-5 times the physical RAM of the server.
    Likewise the number of concurrent database connections (config parameter terminals) should be something about 2-6 times the number of CPU threads.
    Last but not least benchmark runs are normally done for hours, if not days. This is because on the database sizes above it will take that long to reach a steady state and make sure that all performance relevant functionality of the database, like checkpointing and vacuuming, is included in the measurement.
    So you can see that with a modern server, that has 32-256 CPU threads and 64-512GBi, of RAM we are talking about thousands of warehouses and hundreds of concurrent database connections.

    5、Build the schema and initial database load

    创建模式和初始化数据库:

    ./runDatabaseBuild.sh my_postgres.properties > load_`date '+%Y-%m-%d-%H%M'`.log 2>&1 &
    tail -100f load_*.log

    6、如果 oracle 数据库,执行测试前可先生成一个awr快照

    exec dbms_workload_repository.create_snapshot();

    7、Run the configured benchmark

    执行测试:

    ./runBenchmark.sh my_postgres.properties > run_`date '+%Y-%m-%d-%H%M'`.log 2>&1 &
    tail -100f run_*.log

    The benchmark should run for the number of configured concurrent connections (terminals) and the duration or number of transactions.

    8、如果 oracle 执行测试后,再生成一个awr快照,然后获取测试期间的 awr 报告

    exec dbms_workload_repository.create_snapshot();

    9、Scale the benchmark configuration.

    Change the my_postgres.properties file to the correct scaling (number of warehouses and concurrent connections/terminals). Switch from using a transaction count to time based:
    runTxnsPerTerminal=0
    runMins=5

    10、Rebuild the database

    重新创建测试库:
    ./runDatabaseDestroy.sh my_postgres.properties
    ./runDatabaseBuild.sh my_postgres.properties
    为了方便多次测试,减少导入数据的时间,可以通过停止数据库,将整个数据目录执行一次拷贝对数据库进行备份。

    11、Result report

    生成数据库测试报告:
    ./generateReport.sh pg_result_2024-07-31_195621
    生成报告时,如果提示"无法打开链结到X11显示",则需开启 vncserver 服务

    12、配置 R

    wget https://mirrors.tuna.tsinghua.edu.cn/CRAN/src/base/R-4/R-4.4.1.tar.gz
    ./configure
    make -j18
    make install

    —configure 如果错误较多,缺啥装啥:
    yum install -y gcc gcc-c++ gcc-gfortran readline-devel
    yum install -y gcc-gfortran

    如报错:configure: error: –with-x=yes (default) and X11 headers/libs are not available
    yum install -y libX11-devel libXt-devel
    yum install -y zlib-devel bzip2-devel

    如报错:liblzma library and headers are required
    yum install -y xz-devel
    yum install -y pcre2-devel

    如报错:configure: error: libcurl >= 7.28.0 library and headers are required with support for https
    yum install -y libcurl-devel

    ■ 不支持 png 的解决办法
    yum install -y libpng-devel libtiff-devel libjpeg-turbo-devel pango-devel
    再次 configure 即可!

    正确结果应该是 png TRUE, bitmapType 是 cairo,如下:

    R
    capabilities()
    > capabilities()
           jpeg         png        tiff       tcltk         X11        aqua 
           TRUE        TRUE        TRUE       FALSE        TRUE       FALSE 
       http/ftp     sockets      libxml        fifo      cledit       iconv 
           TRUE        TRUE       FALSE        TRUE        TRUE        TRUE 
            NLS       Rprof     profmem       cairo         ICU long.double 
           TRUE        TRUE       FALSE       FALSE       FALSE        TRUE 
        libcurl 
           TRUE
    getOption("bitmapType")
    [1] "cairo"

    ■ 以下是使用 Cairo 配置支持 png【可选】
    wget https://mirrors.tuna.tsinghua.edu.cn/CRAN/src/contrib/png_0.1-8.tar.gz
    wget https://mirrors.tuna.tsinghua.edu.cn/CRAN/src/contrib/Cairo_1.6-2.tar.gz

    install.packages("Cairo_1.6-2.tar.gz",repos=NULL)
    报错:configure: error: Cannot find cairo.h!
    yum install -y cairo libxt

    install.packages("png_0.1-8.tar.gz",repos=NULL)
    library(Cairo)
    library(png)
    Cairo.capabilities()
    ---
         png     jpeg     tiff      pdf      svg       ps      x11      win
        TRUE     TRUE     TRUE     TRUE     TRUE     TRUE     TRUE    FALSE
      raster freetype harfbuzz
        TRUE     TRUE    FALSE
  • BigCloud Enterprise Linux 8和Rocky Linux 8升级OpenSSH步骤

    之前陆续整理过好几次升级openssh的文章,随着时间的推移,也该更新了,正好当下这个升级需求比较多,尤其是安全扫描时往往大部分高危漏洞来自于低版本的openssh,升级后可以解决大部分漏洞。

    根据最近的实践,以下操作适应于如下linux版本:
    BigCloud Enterprise Linux 8.2/8.6
    Rocky Linux 8.10
    bclinux/bc-linux/bc linux

    一、配置telnet服务、gcc编译器

    目的:确保不会因为升级ssh失误导致无法远程登陆主机
    ■ 确认telnet服务是否已经安装
    yum info telnet*
    ■ 如果没有安装telnet-server
    yum install telnet-server -y
    ■ linux7
    安装了telnet-server后,可直接启动telnet-server,不必配置xinetd
    systemctl start telnet.socket
    ■ 此时测试能否远程telnet登陆服务器,确认telnet服务生效后,就可以进行下一步
    ■ 安装openssh需gcc编译器,确认是否安装
    yum info gcc
    如没有安装,则安装:
    yum install gcc

    二、安装新版本zlib【可选】

    一般linux8版本的zlib库版本不需要升级

    三、安装新版本openssl【可选】

    一般linux8版本的openssl库版本不需要升级

    四、备份老版本openssh

    tar cvf /root/sshd20250210.tar /usr/lib/systemd/system/sshd*
    mv /usr/lib/systemd/system/sshd-keygen.target{,.ori}
    mv /usr/lib/systemd/system/sshd.service{,.ori}
    mv /usr/lib/systemd/system/sshd.socket{,.ori}
    mv /usr/lib/systemd/system/[email protected]{,.ori}
    mv /usr/lib/systemd/system/[email protected]{,.ori}
    mv /etc/ssh{,.ori}

    五、安装新版本openssh

    1、官网下载最新版本源码

    【版本9.9p1】
    www.openssh.com
    最新版本国内镜像地址见下一步。

    2、配置、编译、安装

    wget https://mirrors.aliyun.com/pub/OpenBSD/OpenSSH/portable/openssh-9.9p1.tar.gz
    tar xvfz openssh-*.tar.gz
    cd openssh-9.9p1
    ./configure --prefix=/usr/local --sysconfdir=/etc/ssh --with-pam --with-zlib --with-md5-passwords
    此时可能会报错:
    checking for openssl... /usr/bin/openssl
    configure: error: *** working libcrypto not found, check config.log
    则需安装 openssl-devel:yum install -y openssl-devel
    或者报错:找不到pam文件头,则安装pam-devel包即可:
    yum install pam-devel -y
    make
    make install

    注:prefix指定安装路径/usr/local;sysconfdir指定配置文件路径;with-zlib指定新版本zlib路径;with-pam指定启用pam支持;with-ssl-dir指定openssl路径

    六、配置新的sshd系统服务

    1、生成新的服务配置文件,3个

    cat > /usr/lib/systemd/system/sshd-keygen.service << EOF
    [Unit]
    Description=OpenSSH Server Key Generation
    ConditionPathExists=|!/etc/ssh/ssh_host_rsa_key
    ConditionPathExists=|!/etc/ssh/ssh_host_ecdsa_key
    ConditionPathExists=|!/etc/ssh/ssh_host_ed25519_key
    ConditionPathExists=|!/etc/ssh/ssh_host_dsa_key
    PartOf=sshd.service sshd.socket
    
    [Service]
    ExecStart=/usr/local/bin/ssh-keygen
    Type=oneshot
    RemainAfterExit=yes
    EOF
    
    ---
    
    cat > /usr/lib/systemd/system/sshd.service << EOF
    [Unit]
    Description=OpenSSH server daemon
    After=network.target sshd-keygen.service
    Wants=sshd-keygen.service
    
    [Service]
    EnvironmentFile=/etc/sysconfig/sshd
    ExecStart=/usr/local/sbin/sshd -D $OPTIONS
    ExecReload=/bin/kill -HUP $MAINPID
    KillMode=process
    Restart=on-failure
    RestartSec=42s
    
    [Install]
    WantedBy=multi-user.target
    EOF
    
    ---
    
    cat > /usr/lib/systemd/system/sshd.socket << EOF
    [Unit]
    Description=OpenSSH Server Socket
    Conflicts=sshd.service
    
    [Socket]
    ListenStream=22
    Accept=yes
    
    [Install]
    WantedBy=sockets.target
    EOF

    将3个服务配置文件属性改为644
    chmod 644 /usr/lib/systemd/system/sshd*

    2、修改sshd配置

    【make install时自动生成新sshd配置文件】
    参考原sshd配置/etc/ssh/sshd_config,修改新sshd配置
    如下命令行操作,确认端口号,打开PAM支持:

    sed -i "s/#UsePAM no/UsePAM yes/g" /etc/ssh/sshd_config
    打开root登录:
    sed -i "s/#PermitRootLogin prohibit-password/PermitRootLogin yes/g" /etc/ssh/sshd_config

    3、启动sshd服务

    systemctl daemon-reload
    systemctl restart sshd
    systemctl enable sshd

    4、其他修改

    ■ 确认升级后的版本
    telnet localhost 22

    ■ 验证可以远程ssh登陆以后,可以关闭telnet服务
    systemctl stop telnet.socket
    systemctl disable telnet.socket
    如果不能远程登录,一般是因为防火墙和SELINUX设置问题,可以关闭防火墙和关闭SELINUX:
    systemctl stop firewalld
    systemctl disable firewalld
    setenforce 0
    永久关闭selinux,修改/etc/selinux/config 文件:
    sed -i "s/SELINUX=enforcing/SELINUX=disabled/g" /etc/selinux/config

    ■ ssh客户端程序更新
    mv /usr/bin/ssh /usr/bin/ssh.old
    ln -s /usr/local/bin/ssh /usr/bin/ssh

  • 【翻译】凝视深渊:千核并发控制的评估

    凝视深渊:千核并发控制的评估

    作者
    Xiangyao Yu
    MIT CSAIL
    [email protected]

    George Bezerra
    MIT CSAIL
    [email protected]

    Andrew Pavlo
    卡内基梅隆大学
    [email protected]

    Srinivas Devadas
    MIT CSAIL
    [email protected]

    Michael Stonebraker
    MIT CSAIL
    [email protected]

    摘要

    计算机架构正朝着多核时代迈进,单个芯片上集成了数十甚至数百个核心。这种前所未有的片上并行性引入了新的可扩展性维度,而当前的数据库管理系统(DBMS)并未为此设计。特别是随着核心数量的增加,并发控制问题变得极具挑战性。随着数百个线程并行运行,协调对数据的竞争访问的复杂性可能会削弱核心数量增加带来的收益。

    为了更好地理解当前DBMS对未来CPU架构的准备不足,我们对多核芯片上的在线事务处理(OLTP)工作负载进行了并发控制评估。我们在一个主内存DBMS中实现了七种并发控制算法,并使用计算机模拟将系统扩展到1024个核心。我们的分析表明,所有算法都无法扩展到这种规模,但原因各不相同。在每种情况下,我们都识别出与特定数据库实现无关的根本瓶颈,并认为即使是最先进的DBMS也受到这些限制的影响。我们得出结论,与其追求渐进式解决方案,多核芯片可能需要一种从头开始构建并与硬件紧密耦合的全新DBMS架构。

    1 引言

    单线程性能指数级提升的时代已经结束。严格的功耗限制和复杂性迫使芯片设计者从单核转向多核设计。时钟频率在过去几十年中不断提高,但现在增长已经停止。激进的、乱序的、超标量处理器正被简单的、顺序的、单发射核心所取代[1]。我们正在进入多核机器的时代,这些机器由单个芯片上的大量小型、低功耗核心驱动。鉴于当前的功耗限制和单线程处理的低效性,除非出现颠覆性技术,否则增加核心数量是目前架构师能够提高计算能力的唯一途径。这意味着指令级并行性和单线程性能将让位于大规模的线程级并行性。

    随着摩尔定律的继续,单个芯片上的核心数量预计将继续呈指数增长。很快,我们将拥有数百甚至上千个核心的芯片。单节点、共享内存DBMS的可扩展性在多核时代变得更加重要。但如果当前的DBMS技术不适应这一现实,所有这些计算能力都将浪费在瓶颈上,额外的核心将变得无用。

    在本文中,我们窥探了这一严峻的未来,并研究了在一千个核心上进行事务处理时会发生什么。我们没有研究所有可能的可扩展性挑战,而是将范围限制在并发控制上。随着数百个线程并行运行,协调对数据的竞争访问的复杂性将成为可扩展性的主要瓶颈,并可能削弱核心数量增加带来的收益。因此,我们试图通过DBMS中最重要的组件之一来全面研究OLTP DBMS的可扩展性。

    我们在主内存DBMS中实现了七种并发控制算法,并使用高性能的分布式CPU模拟器将系统扩展到1000个核心。从头开始实现系统使我们能够避免现有DBMS中的人为瓶颈,从而理解算法中的更根本问题。之前的可扩展性研究使用了现有的DBMS[24, 26, 32],但这些系统中的许多遗留组件并未针对多核CPU进行优化。据我们所知,尚未有在如此大规模的单DBMS上对多种并发控制算法进行评估的研究。

    我们的分析表明,随着核心数量的增加,所有算法都无法扩展。在每种情况下,我们都识别出与DBMS实现无关的主要瓶颈,并认为即使是最先进的系统也受到这些限制的影响。我们得出结论,要解决这一可扩展性问题,需要与多核架构紧密协同设计的新并发控制方法。与其增加更多核心,计算机架构师将有责任提供硬件解决方案,以解决无法通过软件解决的DBMS瓶颈。

    本文做出了以下贡献:

    • 对七种并发控制方案的可扩展性进行了全面评估。
    • 首次在1000个核心上对OLTP DBMS进行评估。
    • 识别了并发控制方案中的瓶颈,这些瓶颈与具体实现无关。

    本文的其余部分组织如下。我们首先在第2节中概述了评估中使用的并发控制方案。


    VLDB Endowment会议论文集,第8卷,第3期
    版权所有 2014 VLDB Endowment 2150-8097/14/11。

    209

    2 并发控制方案

    OLTP数据库系统支持与最终用户交互的应用程序部分。最终用户通过发送请求与前端应用程序交互,以执行某些功能(例如,预订航班座位)。应用程序处理这些请求,然后在DBMS中执行事务。这些用户可以是个人电脑或移动设备上的人类用户,也可以是运行在世界其他地方的其他计算机程序。

    在这些系统中,事务是在共享数据库上执行一个或多个操作(例如,SQL查询)以执行某些高级功能的序列[17]。它是DBMS中变更的基本单位:不允许部分事务,并且一组事务对数据库状态的影响等同于所有事务的任何串行执行。现代OLTP工作负载中的事务具有三个显著特征:(1)它们是短命的(即没有用户停顿),(2)它们通过索引查找访问一小部分数据(即没有全表扫描或大连接),(3)它们是重复的(即使用不同的输入执行相同的查询)[38]。

    OLTP DBMS需要为每个执行的事务维护四个属性:(1)原子性,(2)一致性,(3)隔离性,(4)持久性。这些统一的概念统称为ACID缩写[20]。并发控制允许多个最终用户以多道程序设计的方式访问数据库,同时保持每个用户都在专用系统上执行其事务的假象[3]。它本质上提供了系统中的原子性和隔离性保证。

    我们现在描述我们在多核评估中探索的不同并发控制方案。对于此讨论,我们遵循经典分类,所有并发方案都是两阶段锁定或时间戳排序协议的变体[3]。表1总结了这些不同的方案。

    两阶段锁定

    两阶段锁定(2PL)是确保数据库系统中并发事务正确执行的第一个可证明正确的方法[12, 6]。在此方案下,事务在对数据库中的某个元素执行读或写操作之前,必须获取该元素的锁。事务在读取该元素之前必须获取读锁,同样在修改该元素之前必须获取写锁。DBMS为每个元组或更高逻辑级别(例如,表、分区)维护锁[14]。

    锁的所有权由两条规则管理:(1)不同事务不能同时拥有冲突锁,(2)一旦事务放弃锁的所有权,它可能永远不会再获取额外的锁[3]。元素上的读锁与同一元素上的写锁冲突。同样,元素上的写锁与同一元素上的写锁冲突。

    在2PL的第一阶段,称为增长阶段,事务可以获取所需的所有锁而不释放锁[12]。当事务释放锁时,它进入第二阶段,称为缩减阶段;此时禁止获取额外的锁。当事务终止(提交或中止)时,所有剩余的锁将自动释放回协调器。

    2PL被认为是一种悲观的方法,因为它假设事务会发生冲突,因此需要获取锁以避免此问题。如果事务无法获取元素的锁,则它被迫等待,直到锁可用。如果这种等待不受控制(即无限期),则DBMS可能会发生死锁[3]。因此,不同2PL变体之间的主要区别在于它们如何处理死锁以及在检测到死锁时采取的措施。我们现在描述我们在评估框架中实现的不同2PL版本,基于这两个细节进行对比:

    带死锁检测的2PL(DL_DETECT): DBMS监控事务的等待图并检查循环(即死锁)[19]。当发现死锁时,系统必须选择一个事务中止并重新启动以打破循环。在实践中,使用集中式死锁检测器进行循环检测。检测器根据事务已使用的资源量(例如,它持有的锁数量)选择要中止的事务,以最小化重新启动事务的成本[3]。

    带非等待死锁预防的2PL(NO_WAIT): 与死锁检测不同,死锁检测是在死锁发生后等待发现死锁,而这种方法更为谨慎,当系统怀疑可能发生死锁时,事务将被中止[3]。当锁请求被拒绝时,调度程序立即中止请求事务(即不允许等待获取锁)。

    带等待死锁预防的2PL(WAIT_DIE): 这是NO_WAIT方案技术的非抢占式变体,其中如果持有锁的事务比请求锁的事务更旧,则允许请求事务等待持有锁的事务。如果请求事务更年轻,则它被中止(因此称为“死亡”)并被迫重新启动[3]。每个事务在执行前需要获取一个时间戳,时间戳顺序保证不会发生死锁。

    时间戳排序

    时间戳排序(T/O)并发控制方案事先生成事务的序列化顺序,然后DBMS强制执行此顺序。事务在执行前被分配一个唯一的、单调递增的时间戳;DBMS使用此时间戳以正确的顺序处理冲突操作(例如,对同一元素的读和写操作,或对同一元素的两个单独的写操作)[3]。

    我们现在描述在我们的测试平台中实现的T/O方案。这些方案之间的关键区别在于:(1)DBMS检查冲突的粒度(即元组与分区),(2)DBMS何时检查这些冲突(即在事务运行时还是在事务结束时)。

    基本T/O(TIMESTAMP): 每次事务读取或修改数据库中的元组时,DBMS将事务的时间戳与上次读取或写入同一元组的事务的时间戳进行比较。对于任何读或写操作,如果事务的时间戳小于上次写入该元组的时间戳,则DBMS拒绝该请求。同样,对于写操作,如果事务的时间戳小于上次读取该元组的时间戳,则DBMS拒绝该请求。在TIMESTAMP中,读查询会创建元组的本地副本以确保可重复读,因为它不受锁保护。当事务中止时,它被分配一个新的时间戳,然后重新启动。这对应于[3]中描述的“基本T/O”算法,但我们的实现使用分散的调度程序。

    多版本并发控制(MVCC): 在MVCC下,每次写操作都会在数据库中创建元组的新版本[4, 5]。每个版本都标记有创建它的事务的时间戳。DBMS维护元素的版本列表。对于读操作,DBMS确定事务将访问此列表中的哪个版本。因此,它确保所有操作的可序列化顺序。MVCC的一个优点是DBMS不会拒绝迟到的操作。也就是说,DBMS不会拒绝读操作,因为它所针对的元素已被另一个事务覆盖[5]。

    乐观并发控制(OCC): DBMS跟踪每个事务的读/写集,并将其所有写操作存储在其私有工作区中[28]。当事务提交时,系统确定该事务的读集是否与任何并发事务的写集重叠。如果不存在重叠,则DBMS将事务工作区中的更改应用到数据库中;否则,事务将被中止并重新启动。这种方法对于主内存DBMS的优势在于,事务仅在提交时将其更新写入共享内存,因此争用期很短[42]。现代OCC实现包括Silo[42]和Microsoft的Hekaton[11, 29]。在本文中,我们的算法与Hekaton类似,因为我们并行化验证阶段,因此比原始算法更具可扩展性[28]。

    带分区级锁定的T/O(H-STORE): 数据库被划分为称为分区的内存子集。每个分区由一个锁保护,并分配一个单线程执行引擎,该引擎对该分区具有独占访问权限。每个事务在开始运行之前必须获取其需要访问的所有分区的锁。这要求DBMS在事务开始之前知道每个事务将访问哪些分区[34]。当事务请求到达时,DBMS为其分配一个时间戳,然后将其添加到其目标分区的所有锁获取队列中。分区的执行引擎从队列中删除事务,并授予其对分区的访问权限,前提是该事务在队列中具有最旧的时间戳[38]。Smallbase是这种方法的早期支持者[22],最近的例子包括H-Store[27]。

    3 多核DBMS测试平台

    由于多核芯片尚不存在,我们通过Graphite[30](一个可以扩展到1024个核心的CPU模拟器)进行了分析。对于DBMS,我们实现了一个主内存OLTP引擎,仅包含我们实验所需的功能。使用自定义DBMS的动机有两个。首先,我们可以确保除了并发控制之外没有其他瓶颈。这使我们能够在不相关功能的干扰下单独研究每个方案的基本原理。其次,由于模拟器的显著减速(例如,Graphite的平均减速为10,000倍),使用全功能DBMS是不切实际的。我们的引擎使我们能够将实验限制在合理的时间内。我们现在描述模拟基础设施、DBMS引擎和本研究中使用的工作负载。

    模拟器和目标架构

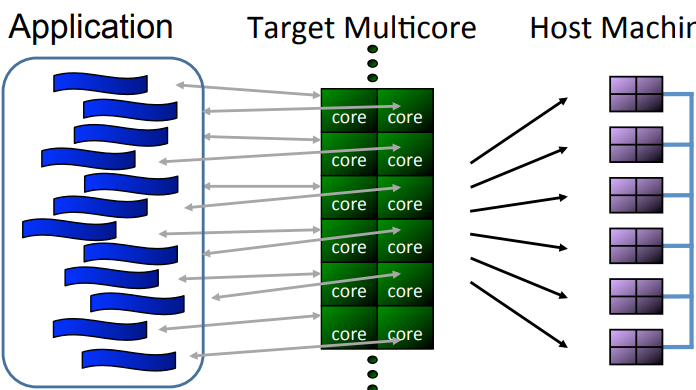
    Graphite[30]是一个用于大规模多核系统的快速CPU模拟器。Graphite通过为架构中的每个核心创建一个单独的线程来运行现成的Linux应用程序。如图1所示,每个应用程序线程都附加到一个模拟核心线程,然后可以将其映射到不同主机上的不同进程。为了提高性能,Graphite放宽了周期准确性,使用周期性同步机制来模拟指令级粒度。与其他类似的CPU模拟器一样,它只执行应用程序,不模拟操作系统。对于本文,我们在一个22节点集群上部署了Graphite,每个节点配备双插槽Intel Xeon E5-2670和64GB DRAM。

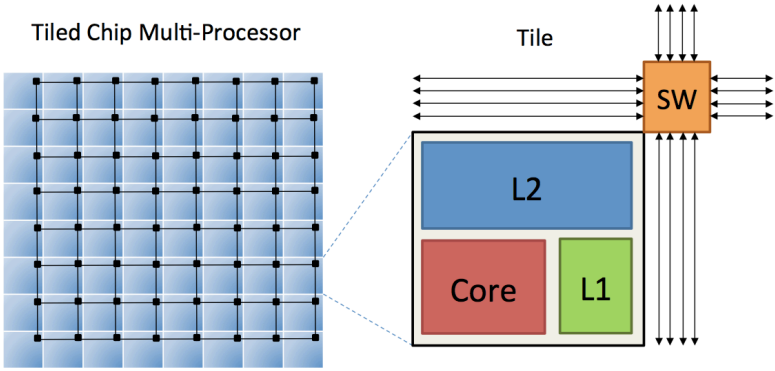
    目标架构是一个平铺的多核CPU,其中每个平铺包含一个低功耗、顺序处理核心、32KB L1指令/数据缓存、512KB L2缓存片和网络路由器。这与其他商用CPU类似,例如Tilera的Tile64(64核)、Intel的SCC(48核)和Intel的Knights Landing(72核)[1]。平铺通过高带宽的2D网格片上网络互连,每跳需要两个周期。平铺和网络的时钟频率均为1GHz。图2描绘了64核机器的架构示意图。

    我们使用共享L2缓存配置,因为它是商用多核最常见的最后一级缓存设计。在共享和私有L2缓存的比较实验中,我们观察到共享缓存由于增加了聚合缓存容量,导致OLTP工作负载的内存流量显著减少,性能更高(结果未显示)。由于L2片分布在不同的平铺中,模拟的多核系统是一个NUCA(非统一缓存访问)架构,其中L2缓存延迟随着2D网格中的距离增加而增加。

    DBMS

    我们基于pthreads实现了自己的轻量级主内存DBMS,以在Graphite中运行。它作为单个进程执行,工作线程数量等于核心数量,每个线程映射到不同的核心。我们DBMS中的所有数据都以行方式存储在内存中。系统支持基本的哈希表索引和可插拔的锁管理器,允许我们交换第2节中描述的不同并发控制方案的实现。它还允许索引和锁管理器进行分区(如H-STORE方案)或以集中模式运行。

    图1:Graphite模拟器基础设施——应用程序线程映射到部署在多个主机上的模拟核心线程。
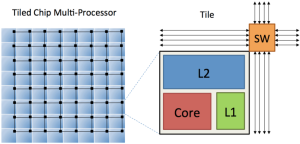

    图2:目标架构——具有64个平铺和2D网格片上网络的平铺芯片多处理器。每个平铺包含一个处理核心、L1和L2缓存以及网络交换机(SW)。

    工作负载

    我们接下来描述我们在测试平台中实现的两个基准测试,用于此分析。

    YCSB: Yahoo! Cloud Serving Benchmark是一组代表互联网公司创建的大规模服务的工作负载[8]。对于本文中的所有YCSB实验,我们使用了一个包含2000万条记录的YCSB数据库,大小约为20GB。每个YCSB元组有一个主键列和10个附加列,每个列包含100字节的随机生成字符串数据。DBMS为主键创建了一个哈希索引。

    YCSB工作负载中的每个事务默认访问数据库中的16条记录。每次访问可以是读取或更新。事务在其程序逻辑中不执行任何计算。所有查询彼此独立;即,一个查询的输入不依赖于前一个查询的输出。YCSB中访问的记录遵循Zipfian分布,该分布由称为theta的参数控制,该参数影响基准测试中的争用级别[18]。当theta=0时,所有元组以相同的频率访问。但当theta=0.6或theta=0.8时,数据库中10%的元组热点分别被约40%和60%的事务访问。

    TPC-C: 该基准测试是评估OLTP系统性能的当前行业标准[40]。它由九个表组成,模拟了一个以仓库为中心的订单处理应用程序。TPC-C中的所有事务都提供一个仓库ID作为事务的输入参数,这是除ITEM表之外所有表的祖先外键。对于需要数据分区的并发控制算法(即H-STORE),TPC-C基于此仓库ID进行分区。

    在我们的模拟中,TPC-C的五个事务中只有两个(Payment和NewOrder)被建模。由于这两个事务占TPC-C总工作负载的88%,因此这是一个很好的近似。我们的TPC-C版本是一个“善意”的实现,尽管我们省略了工作线程的“思考时间”。每个工作线程在不暂停的情况下发出事务;这减轻了随着并发事务数量增加而增加数据库大小的需要。
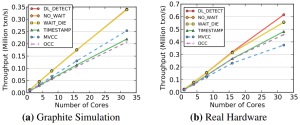

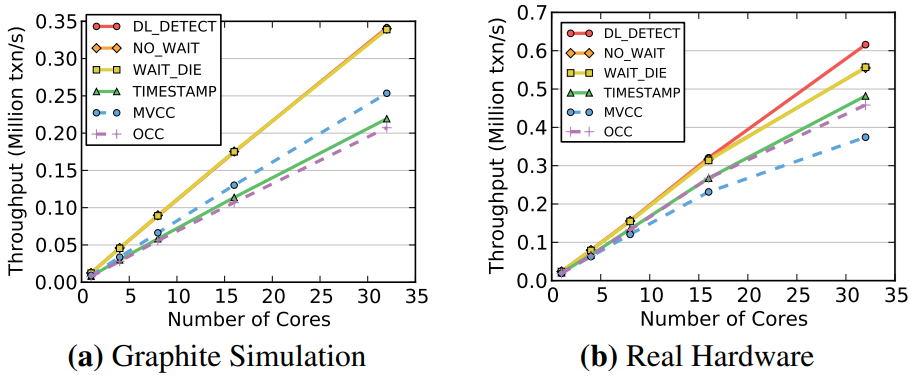
    图3:模拟器与真实硬件的对比——使用中等争用(theta=0.6)的YCSB工作负载,在Graphite和真实多核CPU上运行的并发控制方案的比较。
    Figure 3: Simulator vs. Real Hardware – Comparison of the concurrency control schemes running in Graphite and a real multi-core CPU using the YCSB workload with medium contention (theta=0.6).

    模拟器与真实硬件

    为了证明使用Graphite模拟器生成的结果与现有硬件相当,我们将DBMS部署在Intel Xeon E7-4830上,并执行了一个具有中等争用(theta=0.6)的读密集型YCSB工作负载。然后我们在Graphite中使用相同数量的核心执行相同的工作负载。

    图3中的结果表明,所有并发控制方案在Graphite和真实CPU上表现出相同的性能趋势。然而,我们注意到MVCC、TIMESTAMP和OCC之间的相对性能差异在图3b中有所不同。这是因为MVCC比其他两种方案访问内存更多,而这些访问在两插槽系统上更昂贵。Graphite模拟单个CPU插槽,因此没有插槽间流量。除此之外,基于T/O和WAIT_DIE方案的吞吐量在32核上下降,这是由于时间戳分配期间的跨核通信开销。我们在第4.3节中解决了这个问题。

    4 设计选择与优化

    本研究的主要挑战之一是设计尽可能可扩展的DBMS和并发控制方案。当在1000个核心上部署DBMS时,实现的许多次要方面会成为性能的障碍。我们尽最大努力优化每个算法,消除所有可能的可扩展性瓶颈,同时保持其基本功能。大部分工作是为了消除共享数据结构并设计经典算法的分布式版本[3]。

    在本节中,我们讨论了开发多核OLTP DBMS的经验,并重点介绍了我们为实现可扩展系统所做的设计选择。此外,我们还识别了2PL和T/O方案的基本瓶颈,并展示了硬件支持如何缓解这些问题。我们在第5节中详细分析了各个方案。

    通用优化

    我们首先讨论为提高DBMS在所有并发控制方案中的性能而添加的优化。

    内存分配: 当我们尝试将DBMS扩展到大量核心时,遇到的第一个限制是malloc函数。当使用Linux默认版本的malloc时,我们发现DBMS大部分时间都在等待内存分配。即使对于只读工作负载,这也是一个问题,因为DBMS仍然需要为TIMESTAMP中的读取复制记录,并为访问跟踪数据结构创建内部元数据句柄。我们尝试运行优化版本(TCMalloc[15],jemalloc[13]),但两者都产生了类似的令人失望的结果。

    我们通过编写自定义的malloc实现克服了这个问题。与TCMalloc和jemalloc类似,每个线程都分配了自己的内存池。但不同之处在于,我们的分配器根据工作负载自动调整池的大小。例如,如果基准测试频繁分配大块连续内存,则池大小会增加以分摊每次分配的成本。

    锁表: 正如之前的工作[26, 36]所指出的,锁表是DBMS中的另一个关键争用点。我们没有使用集中式锁表或时间戳管理器,而是以每个元组的方式实现了这些数据结构,每个事务只锁定它需要的元组。这提高了可扩展性,但增加了内存开销,因为DBMS需要为锁共享者/等待者信息维护额外的元数据。在实践中,对于大元组来说,这些元数据(几个字节)可以忽略不计。

    互斥锁: 访问互斥锁是一项昂贵的操作,需要跨芯片发送多条消息。由互斥锁保护的中央关键部分将限制任何系统的可扩展性(参见第4.3节)。因此,重要的是避免在关键路径上使用互斥锁。对于2PL,保护集中式死锁检测器的互斥锁是主要瓶颈,而对于T/O算法,用于分配唯一时间戳的互斥锁是主要瓶颈。在后续章节中,我们描述了为消除这些互斥锁需求而开发的优化。

    可扩展的两阶段锁定

    我们接下来讨论2PL算法的优化。

    死锁检测: 对于DL_DETECT,我们发现当多个线程竞争更新集中式数据结构中的等待图时,死锁检测算法是一个瓶颈。我们通过将数据结构分区到各个核心并使死锁检测器完全无锁来解决这个问题。现在,当事务更新其等待图时,其线程无需任何锁即可更新其队列中的等待事务。此步骤是局部的(即没有跨核通信),因为线程不会写入其他事务的队列。

    在死锁检测过程中,线程通过仅读取相关线程的队列而不锁定队列来搜索部分等待图中的循环。尽管这种方法可能不会在死锁形成后立即发现死锁,但线程保证在后续遍历中发现它[5]。

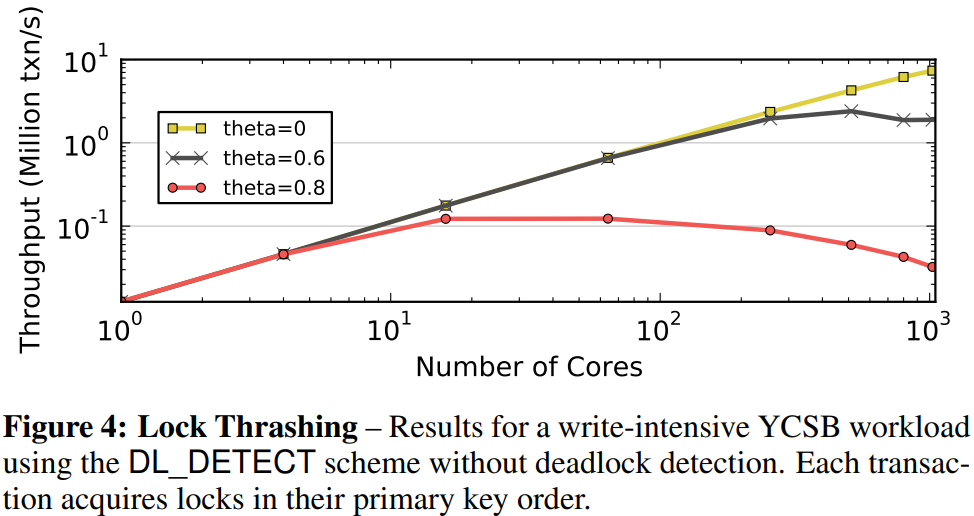
    锁抖动: 即使改进了检测,DL_DETECT仍然由于锁抖动而无法扩展。当事务在提交之前一直持有锁时,会阻塞所有试图获取这些锁的并发事务。这在高争用和大量并发事务的情况下成为一个问题,因此是所有2PL方案的主要瓶颈。
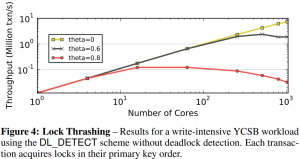

    为了展示抖动的影响,我们执行了一个写密集型YCSB工作负载(即50/50%读写混合),使用DL_DETECT的变体,其中事务按主键顺序获取锁。尽管这种方法不适用于所有工作负载,但它消除了死锁检测的需要,使我们能够更好地观察抖动的影响。图4显示了不同争用级别下事务吞吐量随核心数量的变化。当工作负载中没有偏斜(theta=0)时,锁的争用较低,吞吐量几乎线性扩展。然而,随着争用级别的增加,抖动开始发生。在中等争用(theta=0.6)下,吞吐量在几百个核心时达到峰值,然后由于抖动而下降。在最高争用级别(theta=0.8)下,DBMS的吞吐量在16个核心时达到峰值,无法进一步扩展。模拟结果显示,几乎所有执行时间都花在等待锁上。因此,锁抖动是限制高争用场景下可扩展性的基于锁的方法的关键瓶颈。

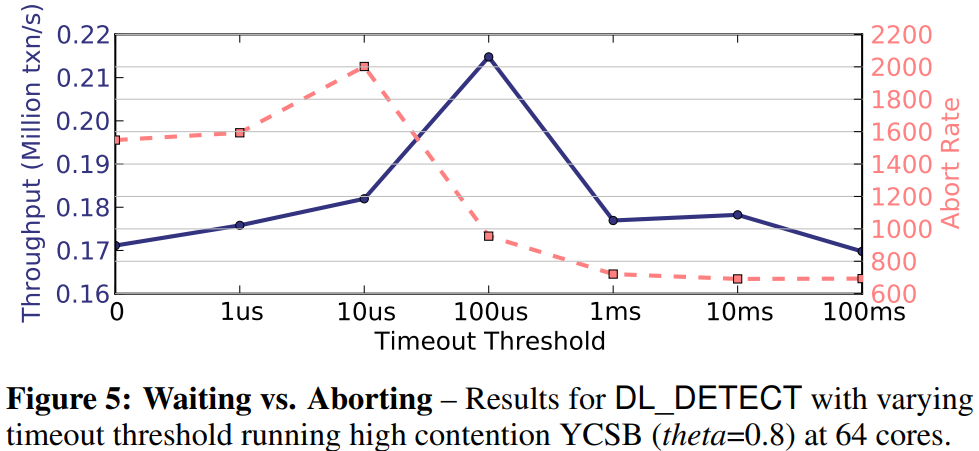
    等待与中止: 在DL_DETECT中,可以通过中止一些事务来减少任何时候的活动事务数量,从而解决抖动问题。理想情况下,这使系统保持在图4中实现的最高吞吐量。我们在DBMS中添加了一个超时阈值,当事务等待锁的时间超过阈值时,系统会中止并重新启动该事务。我们注意到,当超时为零时,此算法等同于NO_WAIT。

    我们在64核CPU上使用不同的超时阈值运行了具有高争用的相同YCSB工作负载。我们测量了DL_DETECT方案的吞吐量和中止率,超时从0-100毫秒不等。
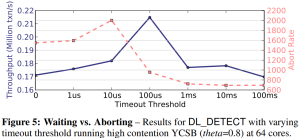

    图5中的结果表明,当CPU核心数量较少时,最好使用较短的超时阈值。这突出了性能与事务中止率之间的权衡。使用较短的超时,中止率较高,这减少了运行事务的数量,缓解了抖动问题。使用较长的超时减少了中止率,但代价是更多的抖动。因此,在本文中,我们将DL_DETECT的超时阈值设置为100微秒。在实践中,阈值应基于应用程序的工作负载特性。

    可扩展的时间戳排序

    最后,我们讨论了为提高基于T/O的算法的可扩展性而开发的优化。

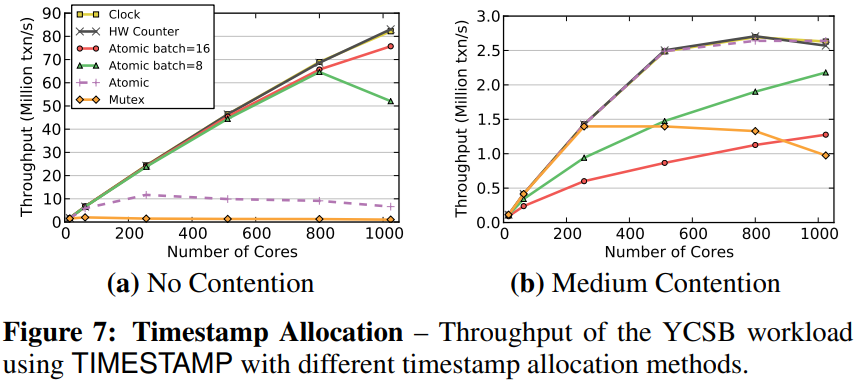
    时间戳分配: 所有基于T/O的算法都基于事务分配的时间戳做出排序决策。因此,DBMS必须保证每个时间戳只分配给一个事务。确保这一点的一种简单方法是在分配器的关键部分使用互斥锁,但这会导致性能不佳。另一种常见的解决方案是使用原子加法操作来推进全局逻辑时间戳。这需要更少的指令,因此DBMS的关键部分被锁定的时间比使用互斥锁更短。但正如我们将展示的,这种方法对于1000核CPU仍然不足。我们现在讨论三种时间戳分配替代方案:(1)带批处理的原子加法[42],(2)CPU时钟,(3)硬件计数器。

    在批处理原子加法方法中,DBMS使用相同的原子指令分配时间戳,但时间戳管理器为每个请求返回多个时间戳。这种方法首次在Silo DBMS中提出[42]。

    使用基于时钟的分配生成时间戳时,每个工作线程从其本地核心读取逻辑时钟,然后将其与线程ID连接。只要所有时钟同步,这种方法就能提供良好的可扩展性。在分布式系统中,同步通过软件协议[31]或外部时钟[9]实现。然而,在多核CPU上,这会带来很大的开销,因此需要硬件支持。截至2014年7月,只有Intel CPU支持跨核心的同步时钟。

    最后,第三种方法是使用高效的硬件计数器。计数器物理上位于CPU的中心,以使到每个核心的平均距离最小化。目前没有现有的CPU支持这一点。因此,我们在Graphite中实现了一个计数器,其中时间戳请求通过片上网络发送,以在单个周期内原子地递增它。
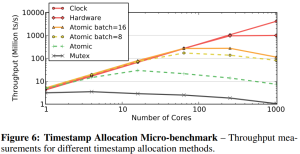

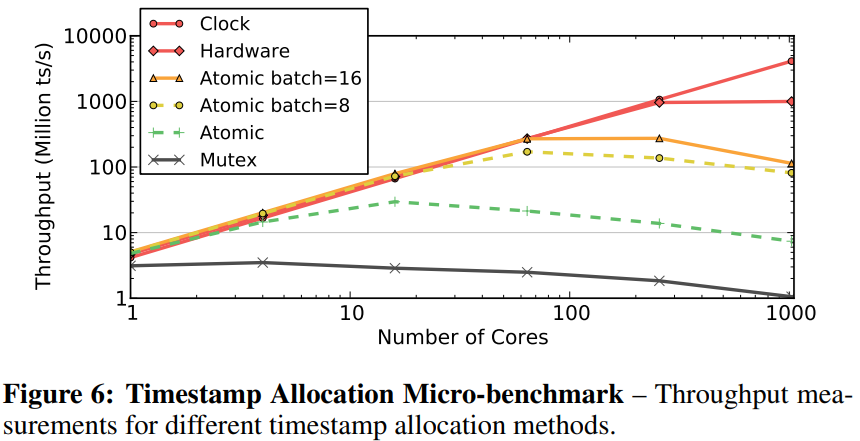
    为了确定DBMS可以为每种方法分配时间戳的最大速率,我们运行了一个微基准测试,其中线程不断获取新的时间戳。图6显示了吞吐量随核心数量的变化。我们首先注意到,基于互斥锁的分配性能最低,在1024核上每秒约100万次时间戳分配(ts/s)。原子加法方法在少量核心时达到每秒3000万次时间戳分配,但随着核心数量的增加,吞吐量下降到每秒800万次。这是由于每次时间戳分配时写回和无效化相应缓存行的缓存一致性流量。这需要跨芯片进行一次往返通信,或在1024核CPU上约100个周期,这转化为在1GHz频率下每秒最多1000万次时间戳分配。批处理这些分配确实有帮助,但在争用情况下会导致性能问题(见下文)。基于硬件的解决方案能够随核心数量扩展。由于使用硬件计数器方法递增时间戳只需一个周期,因此该方法实现了每秒10亿次时间戳分配的最大吞吐量。性能提升来自于通过远程执行加法操作消除了缓存一致性流量。基于时钟的方法具有理想的(即线性)扩展性,因为此解决方案完全分散。
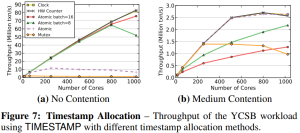

    我们还在DBMS中测试了不同的分配方案,以查看它们在真实工作负载中的表现。在此实验中,我们使用TIMESTAMP方案执行了一个具有两种不同争用级别的写密集型YCSB工作负载。图7a中的结果显示,在没有争用的情况下,分配方法的相对性能与图6中相同。然而,当存在争用时,图7b中的趋势大不相同。首先,使用批处理原子加法方法的DBMS吞吐量要差得多。这是因为当由于冲突而重新启动事务时,它会在同一工作线程中重新启动,并被分配上一批中的下一个时间戳。但这个新时间戳也将小于导致中止的其他事务的时间戳,因此它将不断重新启动,直到线程获取新的一批。非批处理的原子加法方法与时钟和硬件计数器方法表现相当。因此,在本文中,DBMS使用不带批处理的原子加法来分配时间戳,因为其他方法需要目前并非所有CPU都支持的专用硬件支持。

    分布式验证: 原始OCC算法在读取阶段结束时包含一个关键部分,其中将事务的读取集与先前事务的写入集进行比较以检测冲突。尽管此步骤很短,但如上所述,任何受互斥锁保护的关键部分都会严重损害可扩展性。我们通过使用每个元组的验证来解决这个问题,将该检查分解为较小的操作。这与Hekaton[29]中使用的方法类似,但更简单,因为我们只支持每个元组的单一版本。

    本地分区: 我们优化了原始H-STORE协议以利用共享内存。由于DBMS的工作线程在单个进程中运行,我们允许多分区事务直接访问远程分区的元组,而不是发送由远程分区的工作线程执行的查询请求。这允许更简单的实现,比使用进程内通信更快。通过这种方法,数据在物理上并未分区,因为片上通信延迟较低。只读表由所有线程访问而无需复制,从而减少了内存占用。最后,我们使用上述相同的时间戳分配优化,以避免由于时钟偏差而导致的强制等待时间[38]。

    5 实验分析

    我们现在展示不同并发控制方案的分析结果。我们的实验分为两类:(1)可扩展性评估,(2)敏感性评估。对于前者,我们希望确定随着核心数量的增加,这些方案的表现如何。我们将核心数量扩展到1024,同时固定工作负载参数。在敏感性实验中,我们改变单个工作负载参数(例如,事务访问偏斜)。我们报告DBMS的总模拟吞吐量以及每个工作线程在系统不同部分所花费的时间的细分,如第3.2节所列。

    我们首先对YCSB工作负载进行广泛分析。此工作负载的性质允许我们更改其参数并创建各种场景,以不同方式对并发控制方案施加压力。接下来,我们分析TPC-C工作负载,其中我们改变仓库数量并观察对算法吞吐量的影响。H-STORE方案从我们的初始实验中排除,仅在分析数据库分区时在第5.5节中引入。

    只读工作负载

    在第一个可扩展性分析实验中,我们执行了一个由只读事务组成的YCSB工作负载,具有均匀的访问分布。每个事务一次执行16个单独的元组读取。这为每个并发控制方案提供了一个基线,然后我们探索更复杂的工作负载安排。

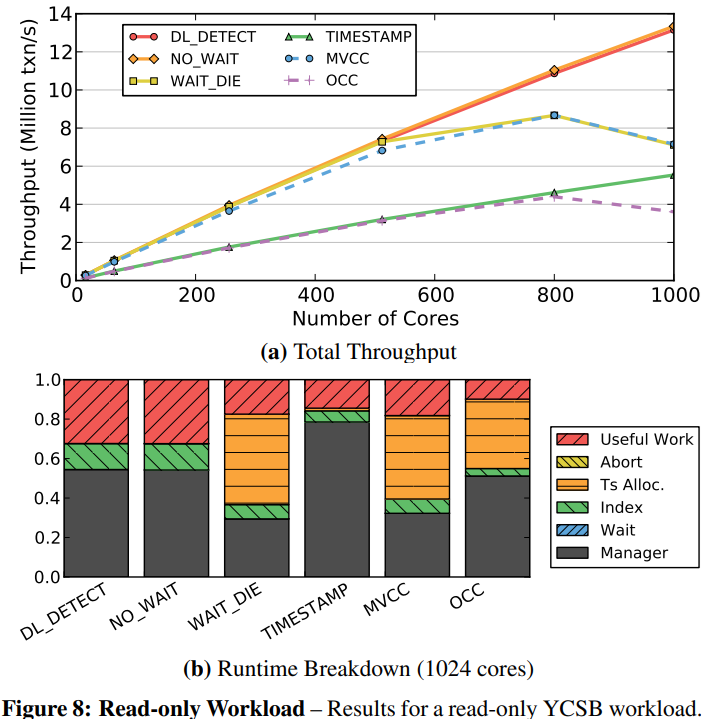
    在完全可扩展的DBMS中,吞吐量应随核心数量线性增加。然而,图8a中的T/O方案并非如此。图8b中的时间细分表明,时间戳分配在大量核心时成为瓶颈。OCC甚至更早遇到瓶颈,因为它需要为每个事务分配两次时间戳(即在事务开始时和验证阶段之前)。无论核心数量如何,OCC和TIMESTAMP的性能都显著低于其他算法。这些算法浪费周期,因为它们复制元组以执行读取,而其他算法则就地读取元组。

    写密集型工作负载

    只读工作负载代表了一种乐观(且不现实)的场景,因为它不会产生数据争用。但即使我们在工作负载中引入写操作,数据集的庞大规模意味着任何两个事务同时访问相同元组的概率很小。实际上,OLTP应用程序的访问分布很少是均匀的。相反,它往往遵循Zipfian偏斜,其中某些元组比其他元组更有可能被访问。这可能是由于数据库中元素的流行度偏斜或基于时间局部性的偏斜(即较新的元组更频繁地被访问)。因此,这增加了争用,因为事务竞争访问相同的数据。

    我们执行了一个由访问16个元组的事务组成的写密集型YCSB工作负载。在每个事务中,每次访问有50%的概率修改元组。工作负载中的偏斜量由参数theta决定(参见第3.3节)。我们使用中等和高争用级别作为事务的访问模式。

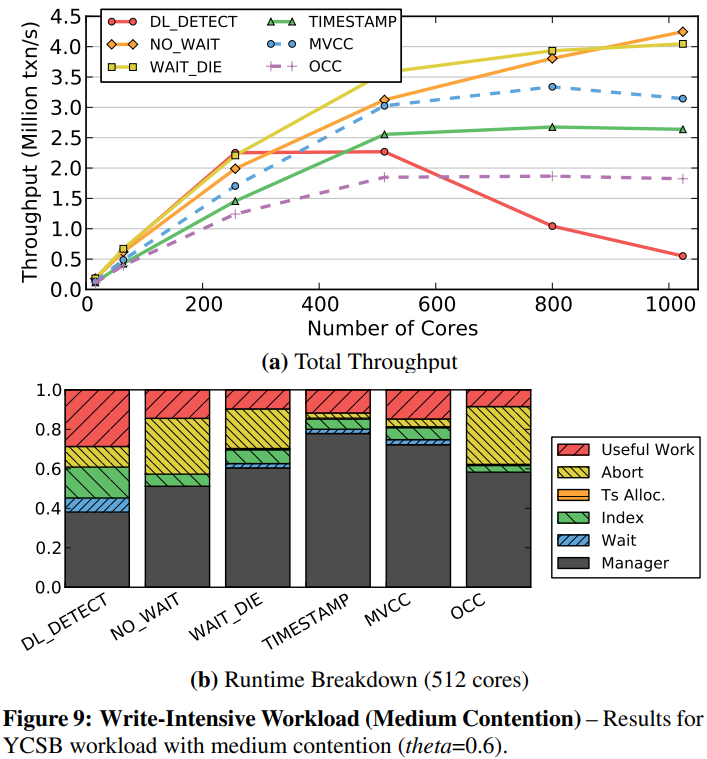
    图9中的中等争用结果显示,NO_WAIT和WAIT_DIE是唯一扩展到512核以上的2PL方案。NO_WAIT比WAIT_DIE扩展得更好。对于DL_DETECT,图9b中的细分表明,DBMS在这些方案中花费了更大比例的时间等待。DL_DETECT在256核时受到锁抖动的抑制。NO_WAIT最具可扩展性,因为它消除了这种等待。然而,我们注意到,NO_WAIT和WAIT_DIE都具有高事务中止率。在我们的实验中这不是问题,因为重新启动中止的事务开销很低;撤销事务所需的时间略少于重新执行事务查询所需的时间。但在现实中,对于需要回滚多个表、索引和物化视图更改的工作负载,开销可能更大。

    图9a中的结果还显示,T/O算法总体上表现良好。TIMESTAMP和MVCC能够重叠操作并减少等待时间。MVCC表现略好,因为它保留了元组的多个版本,因此即使读取请求具有较旧的时间戳,也可以为其提供服务。OCC表现不佳,因为它花费了大量时间中止事务;由于每个事务必须在冲突解决之前完成,开销更大。

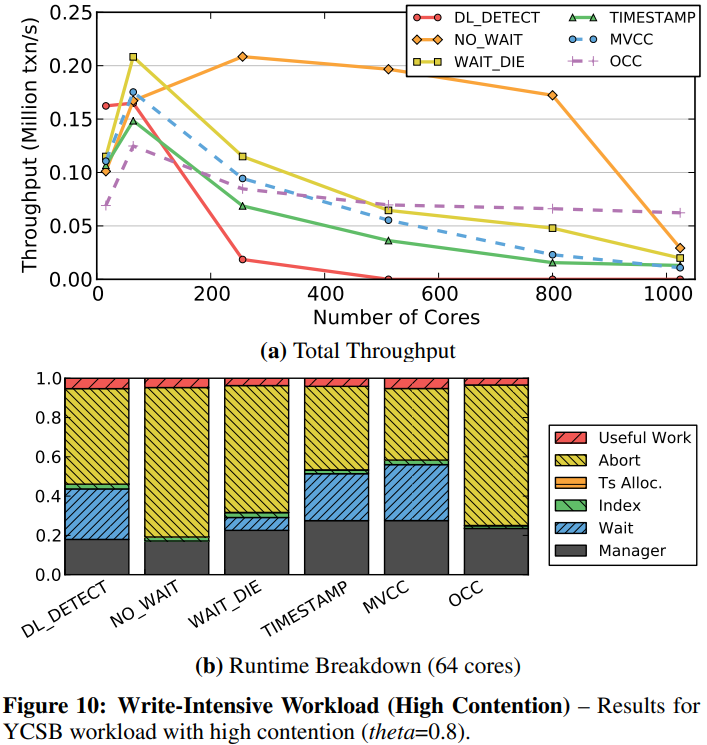
    在更高争用下,图10中的结果显示所有算法的性能都差得多。图10a显示几乎所有方案都无法扩展到64核以上。超过这一点,DBMS的吞吐量停止增加,增加核心数量没有性能优势。NO_WAIT最初优于所有其他方案,但随后屈服于锁抖动(参见图4)。令人惊讶的是,OCC在1024核上表现最佳。这是因为尽管大量事务在验证阶段冲突并必须中止,但始终允许一个事务提交。图10b中的时间细分显示,DBMS在每个方案中花费了更长时间中止事务。

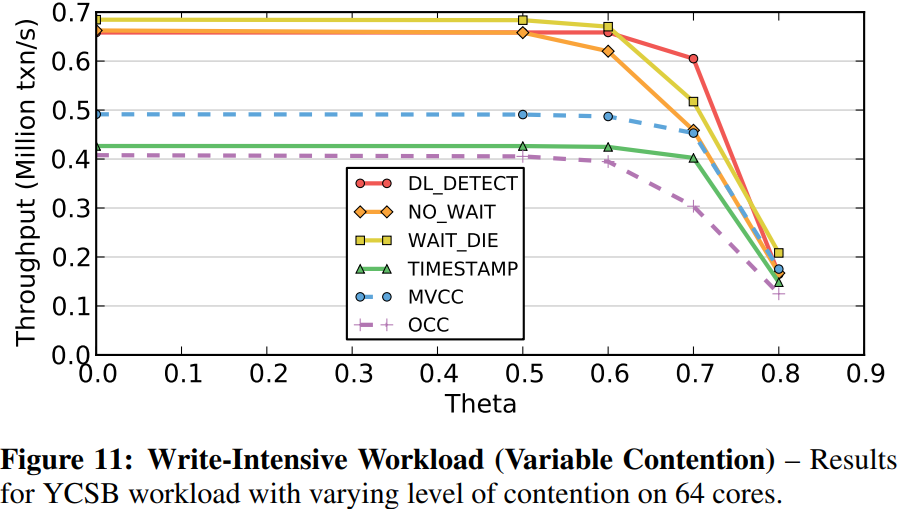
    为了更好地理解每个方案在争用增加时何时开始失效,我们将核心数量固定为64,并对偏斜参数(theta)进行敏感性分析。图11中的结果表明,对于theta值小于0.6,争用对性能影响不大。但对于更高的设置,吞吐量突然下降,使所有算法不可扩展,并且在theta值大于0.8时接近零。
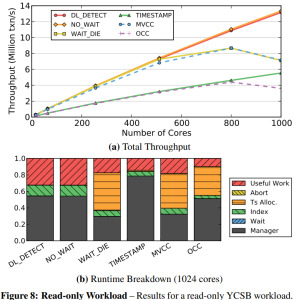

    图8:只读工作负载——只读YCSB工作负载的结果。
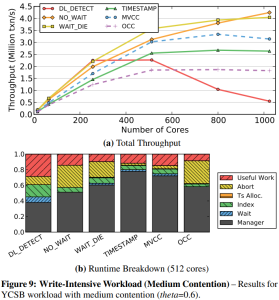

    图9:写密集型工作负载(中等争用)——具有中等争用(theta=0.6)的YCSB工作负载的结果。

    工作集大小

    事务访问的元组数量是影响可扩展性的另一个因素。当事务的工作集较大时,增加了并发事务访问相同数据的可能性。对于2PL算法,这增加了事务持有锁的时间长度。然而,对于T/O,较长的事务可能会减少时间戳分配的争用。在此实验中,我们改变了写密集型YCSB工作负载中每个事务访问的元组数量。由于短事务导致更高的吞吐量,我们测量每秒访问的元组数量,而不是完成的事务数量。我们使用中等偏斜设置(theta=0.6)并将核心数量固定为512。

    图12中的结果显示,当事务较短时,锁争用较低。DL_DETECT和NO_WAIT在此场景中表现最佳,因为死锁很少且中止数量较低。但随着事务的工作集大小增加,DL_DETECT的性能由于抖动开销而下降。对于T/O算法和WAIT_DIE,当事务较短时吞吐量较低,因为DBMS花费了大部分时间分配时间戳。但随着事务变长,时间戳分配成本被分摊。OCC表现最差,因为它为每个事务分配了双倍的时间戳。

    图12b显示了事务长度等于1时的时间细分。再次,我们看到T/O方案花费了大部分执行时间分配时间戳。随着事务变长,图12b和图12b显示分配不再是主要瓶颈。图12中的结果还显示,T/O算法比DL_DETECT更能容忍争用。

    读/写混合

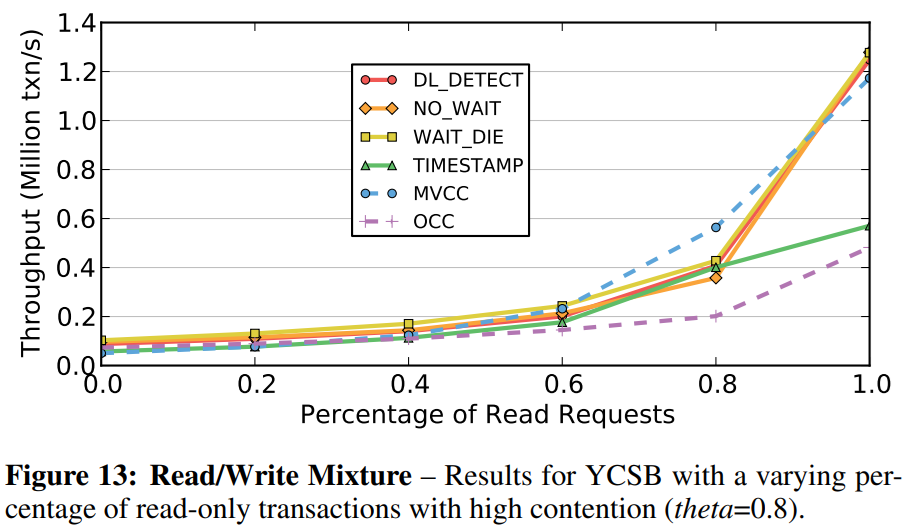
    并发控制的另一个重要因素是事务的读/写混合。更多的写操作会导致更多的争用,以不同方式影响算法。在此实验中,我们在64核配置上使用YCSB,并改变每个事务执行的读查询的百分比。每个事务使用高偏斜设置(theta=0.8)执行16个查询。

    图13中的结果表明,当有更多读事务时,所有算法的吞吐量都更好。在100%读取时,结果与图8a中的先前只读结果匹配。TIMESTAMP和OCC表现不佳,因为它们为读取复制元组。MVCC在少量写事务时表现最佳。这也是支持通过多版本进行非阻塞读取最有效的一个例子;读查询根据时间戳访问元组的正确版本,无需等待写事务。这是与TIMESTAMP的关键区别,在TIMESTAMP中,迟到的查询被拒绝,其事务被中止。

    数据库分区

    到目前为止,在我们的分析中,我们假设数据库作为单个分区存储在内存中,并且所有工作线程都可以访问任何元组。然而,对于H-STORE方案,DBMS将数据库拆分为不相交的子集以提高可扩展性[38]。这种方法只有在数据库以使得大多数事务只需访问单个分区数据的方式进行分区时才能实现良好的性能[34]。当工作负载包含多分区事务时,H-STORE表现不佳,因为其粗粒度锁定方案。每个事务访问的分区数量也很重要;例如,即使只有少量多分区事务,如果它们访问所有分区,H-STORE仍然表现不佳。
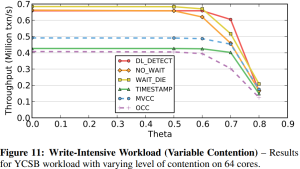

    图11:写密集型工作负载(可变争用)——在64核上具有不同争用级别的YCSB工作负载的结果。
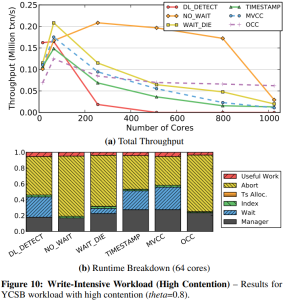

    图10:写密集型工作负载(高争用)——具有高争用(theta=0.8)的YCSB工作负载的结果。
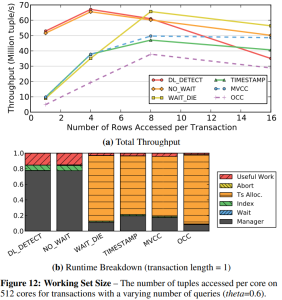

    图12:工作集大小——在512核上,每个核心每秒访问的元组数量,事务具有不同数量的查询(theta=0.6)。

    为了在多核设置中探索这些问题,我们首先在理想条件下将H-STORE与其他六种方案进行比较。然后我们分析其在多分区事务中的性能。

    我们将YCSB数据库划分为与每次试验中的核心数量相同的分区。由于YCSB只有一个表,我们使用简单的哈希策略根据主键将元组分配给分区,以便每个分区存储大致相同数量的记录。这些测试使用写密集型工作负载,其中每个事务执行16个查询,所有查询都使用索引查找,没有任何偏斜(theta=0.0)。我们还假设DBMS在运行时知道在事务开始之前将每个事务分配给哪个分区[34]。

    在第一个实验中,我们执行了一个仅包含单分区事务的工作负载。图14中的结果显示,H-STORE在800核以下优于所有其他方案。由于它专门设计为利用分区,因此其锁定开销比其他方案低得多。但由于H-STORE还依赖于时间戳分配进行调度,因此它受到与其他基于T/O的方案相同的瓶颈的影响。因此,在更高核心数量下性能下降。对于其他方案,分区对吞吐量没有显著影响。然而,可以调整它们的实现以利用分区[36]。

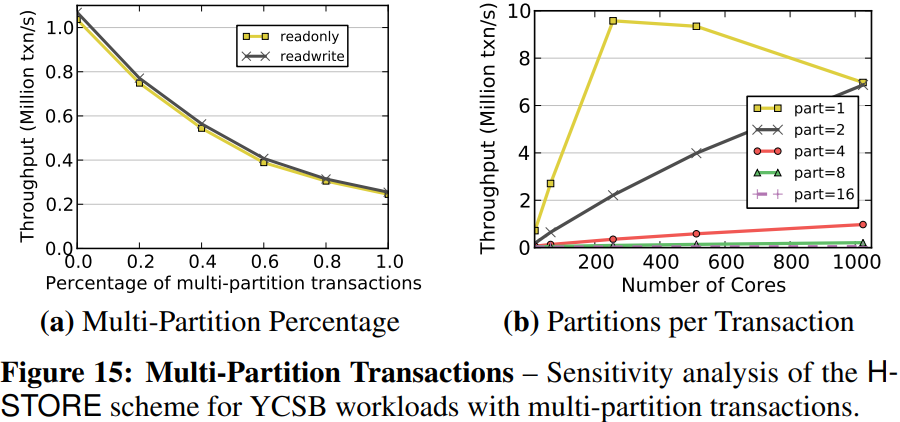
    我们接下来修改了YCSB驱动程序,以改变工作负载中多分区事务的百分比,并在64核CPU上部署了DBMS。图15a中的结果说明了H-STORE方案的两个重要方面。首先,无论工作负载是否包含修改数据库的事务,性能都没有差异;这是因为H-STORE的锁定方案。其次,随着工作负载中多分区事务数量的增加,DBMS的吞吐量下降,因为它们减少了系统中的并行性[34, 42]。

    最后,我们执行了具有10%多分区事务的YCSB,并改变了它们访问的分区数量。图15b中单分区工作负载的DBMS吞吐量表现出与图14中H-STORE相同的时间戳分配下降。这也是为什么在1000核时,单分区和双分区工作负载的吞吐量趋于一致的原因。DBMS无法扩展访问四个或更多分区的事务,因为并行性减少和跨核通信增加。

    TPC-C

    最后,我们分析了所有并发控制算法在运行TPC-C基准测试时的性能。TPC-C中的事务比YCSB中的事务更复杂,代表了一大类OLTP应用程序。例如,它们以读-修改-写访问模式访问多个表,并且某些查询的输出用作同一事务中后续查询的输入。TPC-C事务也可能由于其程序逻辑中的某些条件而中止,而不仅仅是因为DBMS检测到冲突。

    每次试验中的工作负载由50%的NewOrder和50%的Payment事务组成。这两个事务占默认TPC-C混合的88%,并且在复杂性方面最有趣。支持其他事务需要额外的DBMS功能,例如用于并发更新的B树锁定。这将增加系统的额外开销,因此我们将多核CPU上扩展索引的问题留作未来工作。

    TPC-C数据库的大小通常通过仓库数量来衡量。仓库是数据库中几乎所有表的根实体。我们遵循TPC-C规范,其中约10%的NewOrder事务和约15%的Payment事务访问“远程”仓库。对于基于分区的方案,如H-STORE,每个分区包含单个仓库的所有数据[38]。这意味着远程仓库事务将访问多个分区。

    我们首先在具有100MB数据每仓库(总共0.4GB)的4仓库数据库上执行TPC-C工作负载。这使我们能够评估当工作线程数量多于仓库时的算法。然后我们在1024仓库数据库上再次执行相同的工作负载。由于在Graphite模拟器中运行的内存限制,我们将此数据库的大小减少到每仓库26MB(总共26GB)。这不会影响我们的测量,因为每个事务访问的元组数量与数据库大小无关。

    5.6.1 4个仓库
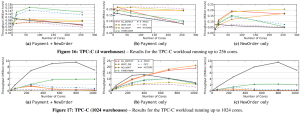

    图16中的结果显示,当仓库数量少于核心数量时,所有方案都无法扩展TPC-C。对于H-STORE,DBMS无法利用额外的核心,因为其分区方案;额外的工作线程基本上处于空闲状态。对于其他方案,图16c中的结果显示,它们能够扩展到64核以处理NewOrder事务。TIMESTAMP、MVCC和OCC由于高中止率而扩展性较差。DL_DETECT由于抖动和死锁而无法扩展。
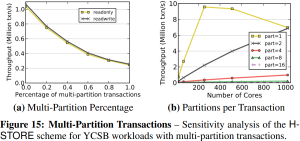

    图15:多分区事务——H-STORE方案对具有多分区事务的YCSB工作负载的敏感性分析。
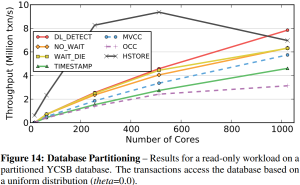

    图14:数据库分区——在分区YCSB数据库上的只读工作负载结果。事务基于均匀分布访问数据库(theta=0.0)。
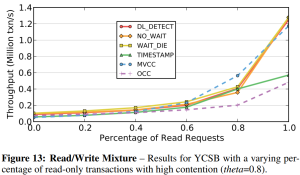

    图13:读/写混合——具有不同百分比只读事务的YCSB结果,具有高争用(theta=0.8)。

    然而,图16b中的结果显示,没有方案能够扩展Payment事务。原因是每个Payment事务更新仓库中的一个字段(N_vTD)。这意味着事务(1)必须获取相应元组的独占锁(即DL_DETECT)或(2)对该字段发出预写(即基于T/O的算法)。如果线程数量大于仓库数量,则更新仓库表成为瓶颈。

    总的来说,这两个事务的主要问题是更新WAREHOUSE表的争用。每个Payment事务更新其相应的仓库条目,每个NewOrder将读取它。对于基于2PL的算法,这些读和写操作相互阻塞。两个基于T/O的算法,TIMESTAMP和MVCC,优于其他方案,因为它们的写操作不会被读操作阻塞。这消除了2PL中的锁阻塞问题。因此,NewOrder事务可以与Payment事务并行执行。

    5.6.2 1024个仓库

    我们接下来在1024个仓库上执行TPC-C工作负载,最多扩展到1024核。再次,我们在图17中看到没有方案能够扩展。结果表明,与第5.6.1节不同,DBMS的吞吐量受限于NewOrder事务。这是由于每个方案的不同原因。

    对于几乎所有方案,主要瓶颈是维护锁和锁存器的开销,即使没有争用也会发生。例如,NewOrder事务从只读ITEM表中读取元组,这意味着对于2PL方案,每次访问都会在DBMS中创建一个共享锁条目。在大量并发事务的情况下,锁元数据变得庞大,因此更新它们需要更长时间。OCC在事务运行时不使用此类锁,但在验证阶段为每个访问的元组使用锁存器。获取这些锁存器对于具有大足迹的事务(如NewOrder)成为一个问题。尽管MVCC也没有锁,但每次读取请求都会生成一个新的历史记录,这会增加内存流量。然而,我们注意到,所有这些在技术上都是不必要的工作,因为ITEM表从未被修改。

    图17b中的结果表明,当仓库数量等于或大于工作线程数量时,Payment事务中的瓶颈被消除。这提高了所有方案的性能。然而,对于T/O方案,吞吐量在更大核心数量下变得过高,因此它们受到时间戳分配的限制。因此,它们无法实现超过约1000万txn/s的吞吐量。这与图12a中的场景相同,其中2PL在短事务中优于T/O。

    H-STORE由于能够利用分区而表现最佳,即使工作负载中约有12%的多分区事务。这证实了先前研究的结果,即当工作负载中少于20%的多分区事务时,H-STORE优于其他方法[34, 42]。然而,在1024核时,它受到DBMS时间戳分配的限制。

    6 讨论

    我们现在讨论前面部分的结果,并提出解决方案以避免多核DBMS的这些可扩展性问题。

    DBMS瓶颈

    我们的评估显示,所有七种并发控制方案都无法扩展到大量核心,但原因和条件各不相同。表2总结了每种方案的发现。特别是,我们确定了几个可扩展性瓶颈:(1)锁抖动,(2)抢占式中止,(3)死锁,(4)时间戳分配,(5)内存到内存复制。

    抖动发生在任何基于等待的算法中。正如第4.2节所讨论的,通过主动中止可以缓解抖动。这导致了中止与性能之间的权衡。总的来说,第5.2节中的结果表明,对于高争用工作负载,非等待死锁预防方案(NO_WAIT)比死锁检测(DL_DETECT)表现更好。

    尽管没有单一的并发控制方案在所有工作负载中表现最佳,但在某些条件下,一个方案可能优于其他方案。因此,可以将两个或多个类别的算法组合到一个DBMS中,并根据工作负载在它们之间切换。例如,DBMS可以在争用较少的工作负载中使用DL_DETECT,但在事务由于抖动而花费太长时间完成时切换到NO_WAIT或基于T/O的算法。还可以采用混合方法,例如MySQL的DL_DETECT + MVCC方案,其中只读事务使用多版本控制,而其他事务使用2PL。

    这些结果还清楚地表明,需要新的硬件支持来克服其中一些瓶颈。例如,所有T/O方案在高吞吐量时都受到时间戳分配瓶颈的影响。当核心数量较大时,使用原子加法方法会导致工作线程发送大量消息跨芯片修改时间戳。我们在第4.3节中展示了时钟和硬件计数器方法如何在没有批处理缺点的情况下表现最佳。因此,我们相信它们应该包含在未来的CPU架构中。

    我们还看到,内存问题导致某些方案的减速。缓解此问题的一种方法是在CPU上添加硬件加速器以在后台进行内存复制。这将消除通过CPU管道加载所有数据的需要。我们还在第4.1节中展示了malloc是另一个瓶颈,我们通过开发支持动态池调整的自定义实现克服了它。但在大量核心的情况下,这些池变得过于庞大,无法在全局内存控制器中管理。我们相信未来的CPU需要切换到分散或分层的内存控制器以提供更快的内存分配。

    多核与多节点系统

    分布式DBMS因其能够扩展到单节点DBMS无法支持的范围而受到赞誉[38]。当节点上的CPU核心数量和可用内存量较小时,这一点尤其正确。但转向多节点架构引入了一个新的性能瓶颈:分布式事务[3]。由于这些事务访问的数据可能不在同一节点上,DBMS必须使用原子提交协议,例如两阶段提交[16]。此类协议的协调开销抑制了分布式DBMS的可扩展性,因为节点之间的网络通信速度较慢。相比之下,共享内存环境中线程之间的通信速度要快得多。这意味着对于除最大的OLTP应用程序之外的所有应用程序,具有大量DRAM的单个多核节点可能优于分布式DBMS[42]。

    对于多节点DBMS,可能需要两个抽象级别:节点之间的无共享实现和单个芯片内的多线程共享内存DBMS。这种层次结构在高性能计算应用程序中很常见。因此,需要更多的工作来研究这种层次化并发控制在OLTP DBMS中的可行性和挑战。

    7 相关工作

    [39]中的工作是对运行OLTP工作负载的DBMS进行的首次硬件分析。他们的评估集中在多处理器系统上,例如如何将进程分配给处理器以避免带宽瓶颈。另一项研究[37]测量了OLTP工作负载中由于缓存未命中导致的CPU停顿时间。这项工作后来在[2]中得到了扩展,最近在[41, 35]中得到了扩展。

    除了H-STORE[14, 22, 38, 43]和OCC[28]之外,我们测试平台中实现的所有其他并发控制方案都源自Bernstein等人的开创性调查[3, 5]。近年来,有几项努力旨在改进这些经典实现的缺点[11, 24, 32, 42]。其他工作包括设计为在多核CPU上更具可扩展性的独立锁管理器[36, 26]。我们现在更详细地描述这些系统,并讨论为什么它们在未来多核架构上仍然不太可能扩展。

    Shore-MT[24]是Shore[7]的多线程版本,采用了类似于DL_DETECT的死锁检测方案。Shore-MT的许多改进来自于优化系统中除并发控制之外的瓶颈,例如日志记录[25]。该系统在高争用工作负载上仍然受到与DL_DETECT相同的抖动瓶颈的影响。

    DORA是建立在Shore-MT上的OLTP执行引擎[32]。与传统的DBMS架构不同,DORA不是将事务分配给线程,而是将线程分配给分区。当事务需要访问特定分区的数据时,其句柄被发送到该分区的相应线程,然后在该线程的队列中等待轮到它。这与H-STORE的分区模型类似,只是DORA支持每个分区的多个记录级锁(而不是每个分区一个锁)[33]。我们研究了在DBMS中实现DORA,但发现它不容易适应,并且需要一个单独的系统实现。

    Silo[42]的作者还观察到全局关键部分是OCC的主要瓶颈。为了克服这一点,他们使用基于批处理原子加法时间戳的分散验证阶段。但正如我们在第4.3节中展示的,当部署在大量核心上时,DBMS必须使用大批量来分摊集中分配的成本。这种批处理反过来增加了系统在争用下的延迟。

    Hekaton[11]是Microsoft SQL Server的主内存表扩展,使用带有无锁数据结构的MVCC变体[29]。管理员将某些表指定为内存表,然后与常规的磁盘驻留表一起访问。Hekaton的主要限制是时间戳分配受到与本文中评估的其他基于T/O的算法相同的瓶颈的影响。

    VLL集中式锁管理器使用每个元组的2PL来消除争用瓶颈[36]。它是DL_DETECT的优化版本,当争用较低时,比我们的实现需要更少的存储和计算开销。VLL通过将数据库划分为不相交的子集来实现这一点。与H-STORE一样,这种技术仅在工作负载可分区时有效。在内部,每个分区仍然有一个关键部分,将在高争用工作负载下限制可扩展性。

    [26]中的工作将锁存器争用确定为MySQL中的主要可扩展性瓶颈。他们通过将原子写后读同步模式替换为读后写方案来消除这种争用。他们还建议批量预分配和释放锁以提高可扩展性。然而,该系统仍然基于集中式死锁检测,因此在数据库中存在争用时会表现不佳。此外,他们的实现需要使用全局屏障,这在更高核心数量下会有问题。

    其他人研究了使用软件-硬件协同设计方法来提高DBMS性能。“仿生数据库”项目[23]与我们的提议类似,但它专注于在FPGA中实现OLTP DBMS操作,而不是直接在CPU上实现新硬件。其他工作专注于OLAP DBMS,因此不适用于我们的问题领域。例如,[10]中提出的基于FPGA的SQL加速器过滤从数据源移动到数据汇的飞行中的数据。它通过使用FPGA加速投影和限制操作来针对OLAP应用程序。Q100项目是用于OLAP查询的特殊硬件协处理器[44]。它假设列式数据库存储,并为每个SQL操作符提供特殊硬件模块。

    8 未来工作

    这项工作揭示了并发控制算法的基本瓶颈,这些瓶颈限制了它们在核心数量增加时的可扩展性。由于这些限制是这些算法固有的,可能不存在软件中的解决方法。在这种情况下,软件-硬件协同设计是解决这些问题的唯一解决方案。对于某些功能,专用硬件可以显著提高性能,同时降低功耗。我们计划研究可能的硬件修改,这些修改可以为OLTP DBMS带来最大的性能提升。

    并发控制只是影响DBMS可扩展性的几个方面之一。要构建真正可扩展的DBMS,还需要研究其他组件。我们计划研究日志记录和索引实现,然后分析这些组件的可能优化。我们还将扩展我们的工作,以包括具有多个多核CPU的多插槽系统。

    9 致谢

    这项研究由英特尔大数据科学与技术中心资助(部分)。我们还向伟大的Phil Bernstein表示衷心的感谢,感谢他的明智反馈。

    10 结论

    本文研究了多核CPU上并发控制算法的可扩展性瓶颈。我们实现了一个轻量级的主内存DBMS,具有可插拔架构,支持七种并发控制方案。我们在分布式CPU模拟器中运行我们的DBMS,该模拟器提供了一个1000核的虚拟环境。我们的结果表明,在所有情况下,没有一个算法能够在如此高的核心数量下获得良好的性能。对于较低核心配置,我们发现基于2PL的方案在处理键值工作负载中常见的低争用短事务时表现良好。而基于T/O的算法在处理更复杂的OLTP工作负载中常见的较高争用和较长事务时表现良好。尽管看起来希望渺茫,但我们提出了几个研究方向,我们计划探索这些方向以纠正这些扩展问题。

    参考文献

    [1] Intel将超级计算能力引入大数据分析。http://intel.ly/18a03f6b,2013年11月。

    [2] A. Aliamati, D. J. DeWitt, M. D. Hill, 和 D. A. Wood. 现代处理器上的DBMS:时间去哪了?在VLDB中,第266-277页,1999年。

    [3] P. A. Bernstein 和 N. Goodman. 分布式数据库系统中的并发控制。ACM计算调查,13(2):185-221,1981年。

    [4] P. A. Bernstein 和 N. Goodman. 多版本并发控制 – 理论与算法。ACM数据库系统汇刊,8(4):463-483,1983年12月。

    [5] P. A. Bernstein, V. Hatzilacos, 和 N. Goodman. 数据库系统中的并发控制与恢复,第5章。1987年。

    [6] P. A. Bernstein, D. Shipman, 和 W. Wong. 数据库并发控制中可串行性的形式化方面。IEEE软件工程汇刊,5(3):203-216,1979年。

    [7] M. J. Carey, D. J. DeWitt, M. J. Franklin, N. E. Hall, M. L. McAuliffe, J. F. Naughton, T. J. Schuh, M. H. Solomon, C. Tan, O. G. Tsatalos, 等. 支持持久性应用程序,第23卷。ACM,1994年。

    [8] B. P. Cooper, A. Silberstein, E. Tam, R. Ramakrishnan, 和 R. Sears. 使用YCSB对云服务系统进行基准测试。在SoCC’10中,第143-154页。

    [9] J. C. Corbett 等. Spanner:Google的全球分布式数据库。在OSDI中,第261-264页,2012年。

    [10] C. Demil, D. Ziener, 和 J. Teich. 使用部分可重构模块库动态组合基于FPGA的SQL查询加速器。在FCCM中,第45-52页,2012年。

    [11] C. Diaconu, C. Freedman, E. Ismeri, P.-A. Larson, P. Mittal, R. Stoneclpher, N. Verm, 和 M. Zwilling. Hekaon:SQL Server的内存优化OLTP引擎。在SIGMOD中,第1243-1254页,2013年。

    [12] K. P. Eswaran, J. N. Gray, R. A. Lorie, 和 I. L. Traiger. 数据库系统中的一致性和谓词锁的概念。ACM通信,19(11):624-633,1976年11月。

    [13] J. Evans. jemalloc. http://camomere.com/jemalloc。

    [14] I. Garcia-Molina 和 K. Salem. 主内存数据库系统:概述。IEEE知识与数据工程汇刊,46(9):509-516,1992年12月。

    [15] S. Ghemawat 和 P. Menage. TCValdoc:线程缓存malloc。http://googleperftools.sourceforge.net/doc/tcmalloc.html。

    [16] J. Gray. 数据库系统中的并发控制与恢复,第393-481页。Springer-Verlag,1978年。

    [17] J. Gray. 事务概念:优点与局限性。在VLDB中,第144-154页,1981年。

    [18] J. Gray, P. Sundaresan, S. Englert, K. Baclawski, 和 P. J. Weinberger. 快速生成十亿条记录的合成数据库。SIGMOD,第243-252页,1994年。

    [19] J. N. Gray, R. A. Lorie, G. R. Putzou, 和 I. L. Traiger. 数据库管理系统中的粒度:共享数据库中的锁粒度和一致性程度,第365-393页,1976年。

    [20] T. Haender 和 A. Reuter. 面向事务的数据库恢复原则。ACM计算调查,15(4):287-317,1983年12月。

    [21] S. Harizopoulos, D. J. Abadi, S. Madden, 和 M. Stonebraker. 透过镜子看OLTP,以及我们在那里发现了什么。在SIGMOD中,第981-992页,2008年。

    [22] M. Heyriess, S. Listgarth, M.-A. Neiman, 和 K. Wilkinson. Smallbase:用于高性能应用程序的主内存DBMS。技术报告,惠普实验室,1995年。

    [23] R. Johnson 和 I. Pandis. 仿生DBMS即将到来,但它会是什么样子?在CIDR中,2013年。

    [24] R. Johnson, I. Pandis, N. Hardavellas, A. Aliamati, 和 B. Falcafi. Store-MT:多核时代的可扩展存储管理器。EDBT,第24-35页,2009年。

    [25] R. Johnson, I. Pandis, R. Stoica, M. Athanassoulis, 和 A. Aliamati. Aether:一种可扩展的日志记录方法。VLDB Endowment会议论文集,3(1-2):681-692,2010年。

    [26] H. Jung, H. Han, A. D. Felcte, G. Heiser, 和 H. Y. Yeom. 多核的可扩展锁管理器。在SIGMOD中,第73-84页,2013年。

    [27] K. Kaliman, H. Kimura, J. Nakita, A. Pavlo, A. Rasio, S. Zdonik, E. P. C. Jones, S. Madden, M. Stonebraker, Y. Zhang, J. Hugg, 和 D. J. Abadi. H-Store:一个高性能的分布式主内存事务处理系统。VLDB Endowment会议论文集,1(2):1496-1499,2008年。

    [28] H. T. Kung 和 J. T. Robinson. 关于并发控制的乐观方法。ACM数据库系统汇刊,6(2):213-226,1981年6月。

    [29] P.-A. Larson, S. Blanas, C. Diaconu, C. Freedman, J. M. Patel, 和 M. Zwilling. 主内存数据库的高性能并发控制机制。VLDB,5(4):298-309,2011年12月。

    [30] J. Miller, H. Kasture, G. Kurian, C. Gruenwald, N. Beckmann, C. Celio, J. Eastep, 和 A. Agarwal. Graphite:一个分布式并行微基准模拟器。在IPCA中,第1-12页,2010年。

    [31] D. L. Mills. 网络时间协议。IEEE通信汇刊,39(10):1482-1493,1991年。

    [32] I. Pandis, R. Johnson, N. Hardavellas, 和 A. Aliamati. 面向事务的数据执行。VLDB Endowment会议论文集,3:928-939,2010年9月。

    [33] I. Pandis, P. Trozin, R. Johnson, 和 A. Aliamati. PLP:无页泄漏的共享一切OLTP。VLDB Endowment会议论文集,4(10):610-621,2011年7月。

    [34] A. Pavlo, C. Curino, 和 S. Zdonik. 共享无并行OLTP系统中的偏斜感知自动数据库分区。在SIGMOD中,第61-72页,2012年。

    [35] D. Porobic, I. Pandis, M. Barroco, P. Trozin, 和 A. Aliamati. 硬件岛上的OLTP。VLDB Endowment会议论文集,5:1447-1458,2012年7月。

    [36] K. Ren, A. Thomson, 和 D. J. Abadi. 主内存数据库系统的轻量级锁定。在VLDB中,第145-156页,2013年。

    [37] M. Rosenblum, E. Bugnion, S. A. Herrod, E. Witchel, 和 A. Gupta. 架构趋势对操作系统性能的影响。在SOSP中,第285-298页,1995年。

    [38] M. Stonebraker, S. Madden, D. J. Abadi, S. Harizopoulos, N. Haehem, 和 P. Helland. 一个架构时代的结束:(是时候进行彻底重写了)。在VLDB中,第1150-1160页,2007年。

    [39] S. S. Thakkar 和 M. Sweiger. OLTP应用程序在对称多处理器系统上的性能。在ISCA中,第228-238页,1990年。

    [40] 事务处理委员会。TPC-C基准测试(修订版5.9.0)。http://www.tpc.org/tpec/spec/tpec_current.pdf,2007年6月。

    [41] P. Trozin, B. Gold, 和 A. Aliamati. OLTP在仙境中:主要OLTP组件中的缓存未命中来自哪里?在DaMoN中,2013年。

    [42] S. Tu, W. Zheng, E. Kohler, B. Liskov, 和 S. Madden. 多核内存数据库中的快速事务。在SOSP中,2013年。

    [43] A. Whitney, D. Shasha, 和 S. Apter. 无并发控制、两阶段提交、SQL或C++的高容量信息处理。在IHYFS’97中。

    [44] L. Wu, A. Lotatarii, T. K. Pains, M. A. Kim, 和 K. A. Ross. Q100:数据库处理单元的架构与设计。在ASPLOS中,2014年。
  • NFS使用TrueNAS SCALE的好处

    之前一直习惯于使用linux自带的NFS服务,但由于NFS空间占用较大自身不带压缩能力,最近使用了号称比较流行的 TrueNAS SCALE 版本,重要的是它还可以提供块服务 Block (iSCSI) Shares Targets。
    关于 TrueNAS SCALE 的安装配置可以网搜获取,此处不赘述,只说要点与结果。

    一、打开SSH服务

    这个在WEB管理界面即可配置,注意打开:
    Allow Password Authentication

    二、安全配置

    限制可以获取NFS输出列表的IP和用户

    root@truenas:~# cat /etc/hosts.{allow,deny}|grep -Pv "^#"
    mountd: 192.168.10.108,192.168.10.68
    rpcbind: 192.168.10.108,192.168.10.68:allow
    mountd: ALL
    rpcbind: ALL:deny

    三、空间占用—对比传统NFS

    1、压缩文件:空间占用差别不大

    -rw-r--r-- 1 root root   55846318 10月 24 10:22 mysqld_109.zip
    -rw-r--r-- 1 root root   60230180 10月 24 10:22 mysqld_110.zip
    -rw-r--r-- 1 root root   70947308 10月 23 18:52 mysqld.zip
    [root@BC86]# du -sh *
    54M     mysqld_109.zip
    58M     mysqld_110.zip
    68M     mysqld.zip
    [root@node1]# du -sh *
    51M     mysqld_109.zip
    58M     mysqld_110.zip
    68M     mysqld.zip

    2、文本文件:空间占用相差巨大

    -rw-r----- 1 root root 1325298318 10月 23 19:22 mysqld.log
    -rw-r----- 1 root root 1445393021 10月 23 19:24 mysqld.log
    [root@BC86]# du -sh 1*
    1.3G    109
    1.4G    110
    [root@node1]# du -sh 1*
    120M    109
    129M    110

    可见 TrueNAS 对这类文件的压缩比率达到了10%左右,效果惊人。

    四、iSCSI 块服务

    传统的关系数据库Oracle需采用共享块存储才能有效配置RAC架构,而普通的NFS服务是很难配置的,至少笔者在配置传统NFS服务时遇到了各种问题,但(据说)iSCSI 块服务一般是没有问题的,这一点尚需验证,不过随着去O进程的接近尾声,后续类似需求会大大减少,如有,TrueNAS 方案不失为一个较好的选择。